Opus 4.6 vs GPT-5.3 Codex: Cosa Cambia Per Chi Sviluppa
Opus 4.6 porta 1M di contesto e Agent Teams. GPT-5.3 Codex è il 25% più veloce. Due rilasci lo stesso giorno: ecco cosa cambia per chi sviluppa.
Alessandro Saiani
Human in the Loop
Il 5 febbraio Anthropic ha rilasciato Claude Opus 4.6. OpenAI ha risposto circa mezz'ora dopo con GPT-5.3 Codex.
Il giorno prima si erano punzecchiati sui social per gli spot del Super Bowl. Il giorno dopo, hanno sincronizzato i rilasci al minuto. Coincidenza? Il mio sospetto è che OpenAI sapesse in anticipo i tempi di Anthropic.
Ma una volta che li usi davvero, la sensazione è che questi due modelli non stiano combattendo la stessa battaglia.
I Punti Chiave
- GPT-5.3 Codex è il 25% più veloce — Codex finalmente non sembra lento
- Claude Opus 4.6 porta il contesto a 1M token e introduce Agent Teams (agenti che lavorano in parallelo)
- Terminal-Bench 2.0: GPT avanti di 12 punti. OSWorld: Claude avanti di 8
- GPT è stato usato per ottimizzare sé stesso. Claude fa un salto enorme nella stabilità su contesti lunghi
- Ognuno ha i suoi punti di forza — non c'è un vincitore assoluto
GPT-5.3 Codex
Qual era il problema storico di Codex? Qualità ottima, ma lento.
Quel +25% di velocità si dovrebbe sentire nell'uso quotidiano. Devo ancora metterci le mani sopra a lungo, ma la direzione è chiara.
In passato usavo Codex quando volevo codice affidabile. L'output era solido, ma l'attesa era dolorosa. Anche quando streamava risultati parziali, non capivi dove stesse andando, se stesse deviando, e non osavi interromperlo.
Questa volta è diverso.
GPT-5.3 Codex spinge sull'interactive coding. Supporta un loop più collaborativo: puoi chiedere "Questo approccio ha senso?" o "Dovremmo cambiare direzione?" e guidarlo in tempo reale.
I numeri:
| Benchmark | GPT-5.3 Codex | Precedente |
|---|---|---|
| Terminal-Bench 2.0 | 77.3% | 64.0% |
| SWE-Bench Pro | 56.8% | — |
| OSWorld | 64.7% | — |
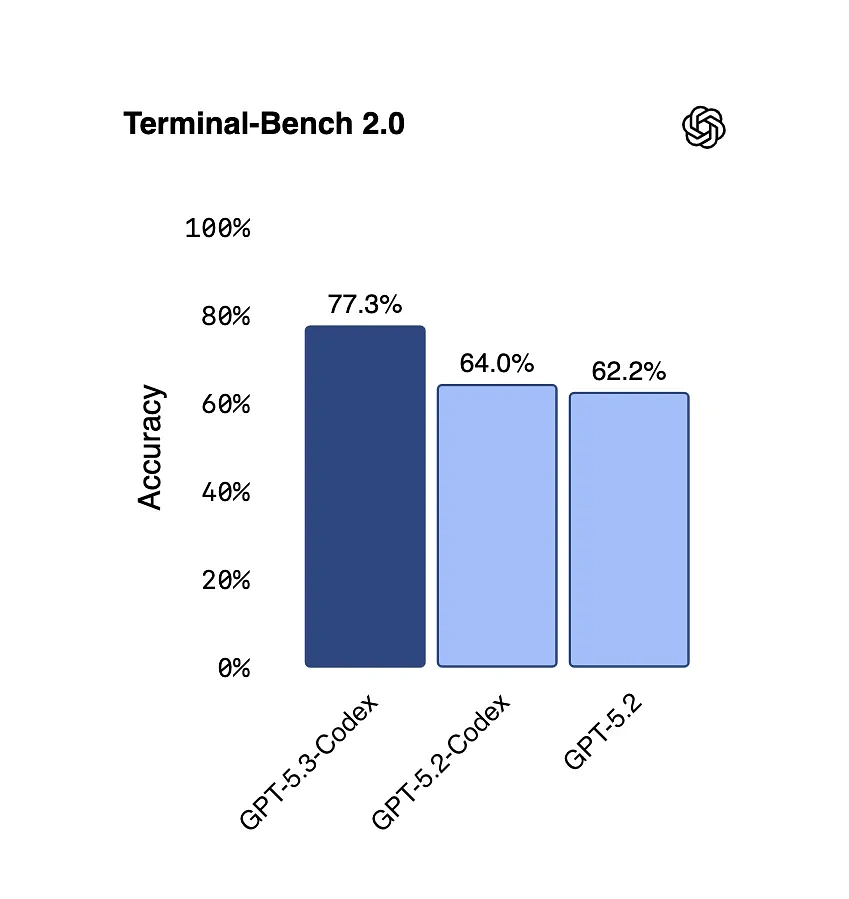
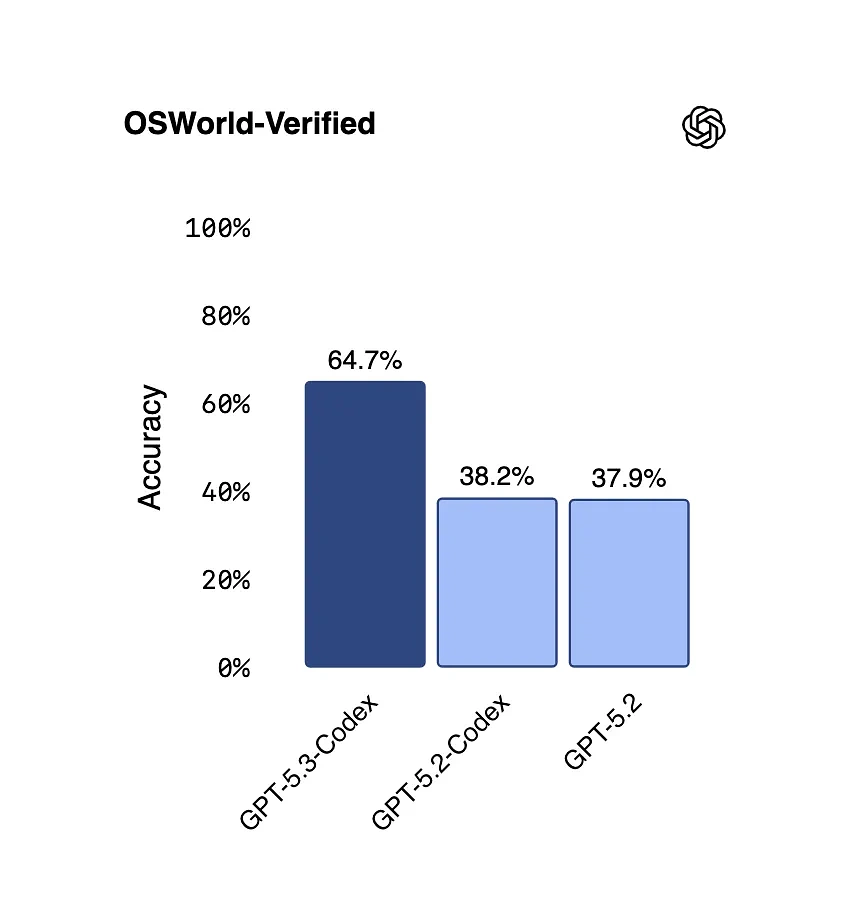
Ma onestamente, il miglioramento nell'interazione conta più della classifica.
C'è anche un dettaglio da fantascienza: è il primo modello (almeno in questa linea di prodotti) usato per ottimizzare sé stesso. Il team OpenAI ha utilizzato versioni preliminari di GPT-5.3 per affinare il proprio training, gestire il deployment e diagnosticare problemi.
Il Lato Ombra: Cybersecurity
GPT-5.3 Codex è il primo modello OpenAI classificato come "High capability" nel dominio cybersecurity secondo il loro Preparedness Framework. L'accesso completo alle API per gli sviluppatori è stato ritardato, e il lancio è avvenuto con controlli più stretti del solito.
Un modello che sa scrivere codice molto bene sa anche trovare (e potenzialmente sfruttare) vulnerabilità molto bene. OpenAI ne è consapevole.
Claude Opus 4.6
Claude questa volta espande Opus a una context window da 1.000.000 di token (ancora in beta), con supporto per output fino a 128k token.
Ma non è solo più contesto. Ci sono tre novità architetturali importanti:
- Adaptive Thinking — il modello decide autonomamente quando serve ragionamento esteso, senza che tu debba chiederlo
- Effort Controls — quattro livelli (low, medium, high, max) per bilanciare intelligenza, velocità e costo
- Context Compaction — nelle conversazioni lunghe, riassume automaticamente il contesto più vecchio per non perdere il filo
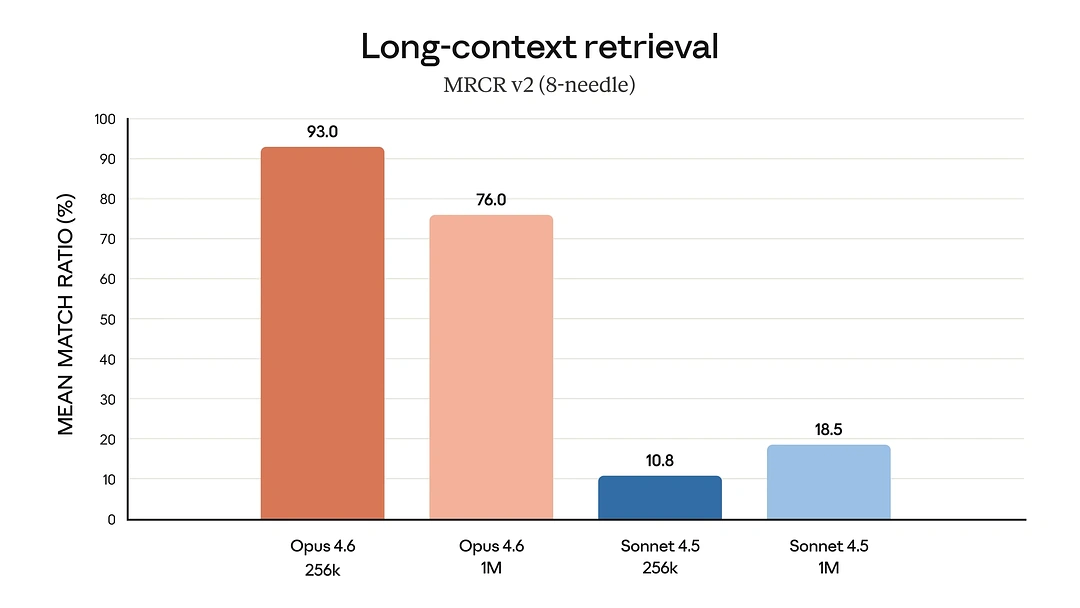
Su MRCR v2 — un test che nasconde 8 "aghi" in un haystack da 1M token — Opus 4.6 ne ha trovati il 76%. Sonnet 4.5 si è fermato al 18.5%. Il divario è enorme.
Cosa si sente in pratica?
Per codebase di grandi progetti, prima dovevi spezzare tutto in chunk o sbattevi contro il limite di contesto. Ora puoi buttarci dentro l'intero progetto, e il modello lo capisce davvero. Non la comprensione di facciata: trova le parti rilevanti, traccia le relazioni, collega i puntini.
Il problema del "context rot" è sostanzialmente risolto. I contesti lunghi facevano deviare i modelli, perdere dettagli chiave. Opus 4.6 che resta stabile a 1M token è genuinamente impressionante.
| Benchmark | Claude Opus 4.6 |
|---|---|
| Terminal-Bench 2.0 | 65.4% (12 punti dietro GPT) |
| SWE-bench Verified | 81.4% |
| OSWorld | 72.7% (8 punti avanti a GPT) |
| GDPval-AA | +144 ELO vs GPT-5.2 |
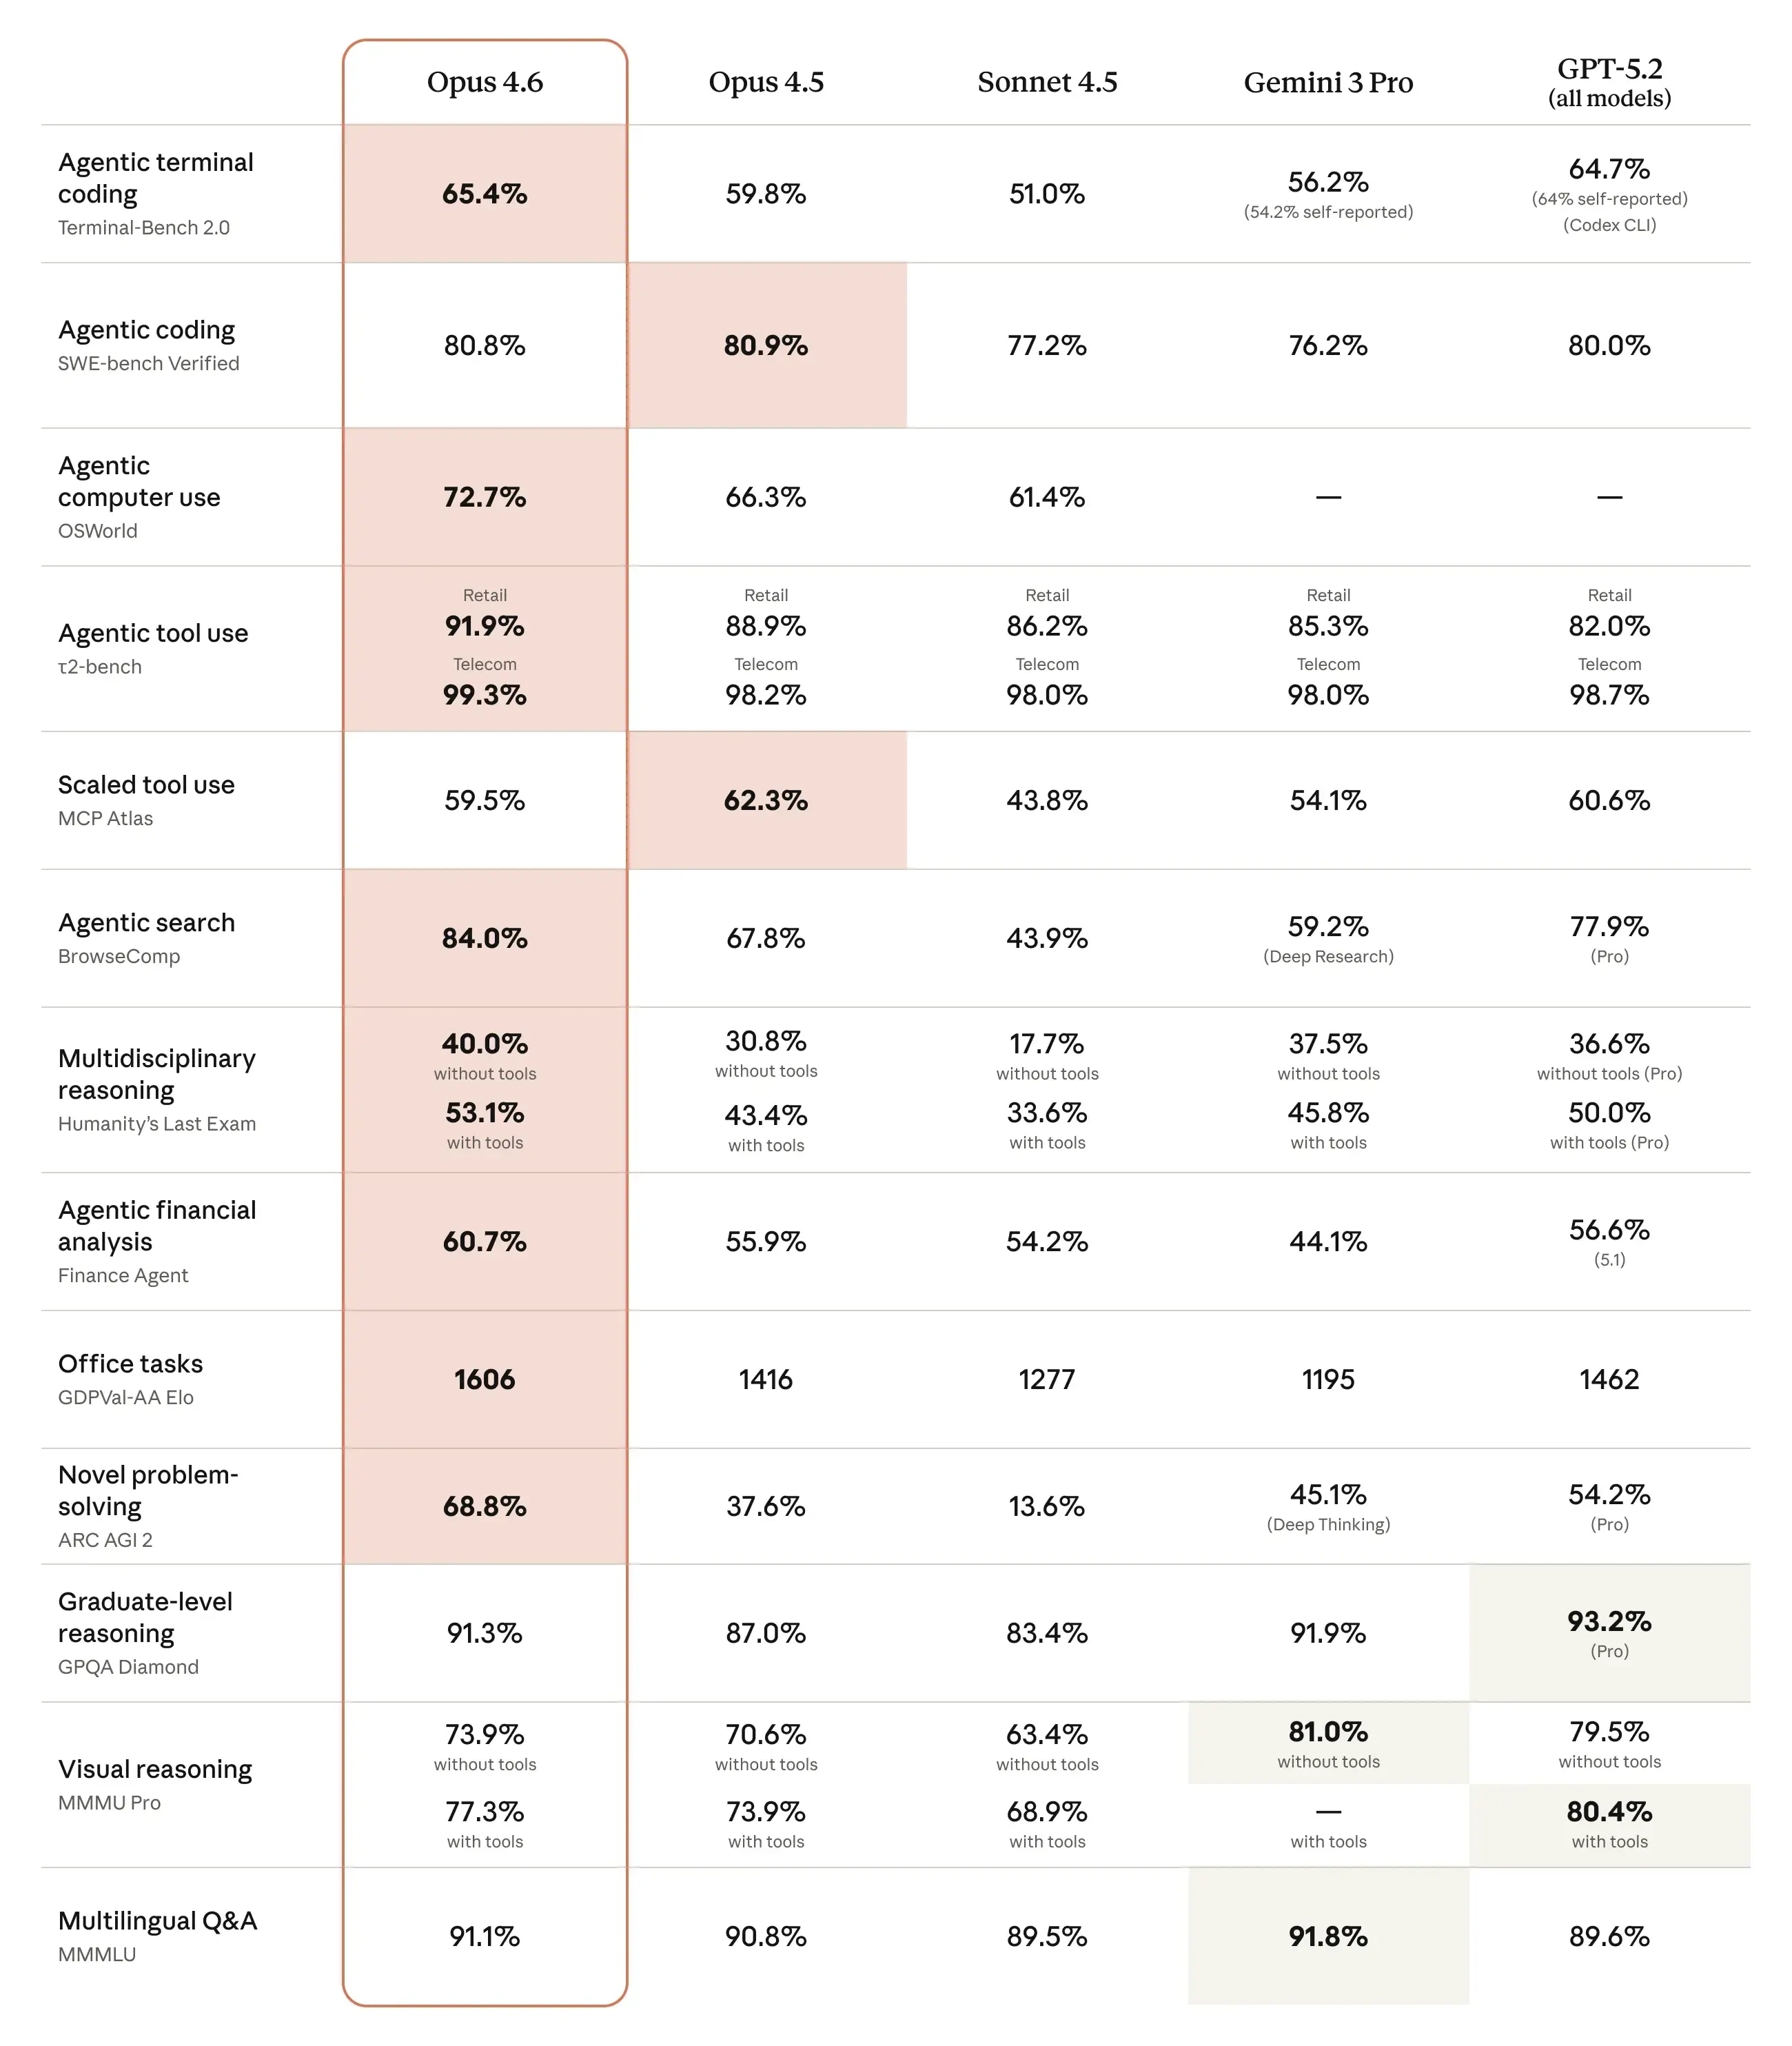
OSWorld misura la capacità di completare task in un ambiente desktop reale. Claude al 72.7% è nettamente sopra il 64.7% di GPT. Su task complessi, multi-step e catene di ragionamento lunghe, Claude è più stabile.
Agent Teams
Oltre all'upgrade del modello, Opus 4.6 porta anche Agent Teams: la possibilità di lanciare più agenti che lavorano in parallelo.
È ancora sperimentale. Permette a più istanze di Claude Code di formare un team e collaborare.
L'architettura ha quattro parti:
- Team Lead — la sessione principale che crea il team, assegna il lavoro e unisce i risultati
- Teammates — istanze separate di Claude Code, ognuna con la propria context window
- Task List — lista condivisa di task che i teammate possono prendere in carico
- Mailbox — sistema di messaggistica tra agenti
La differenza chiave rispetto ai subagent? I teammate possono parlare direttamente tra loro e contestarsi a vicenda, invece di riferire solo al main agent.
Scenario ideale: un teammate sul frontend, uno sul backend, uno sui test. Ognuno lavora indipendentemente ma si coordinano su interfacce e decisioni.
Il Quadro
GPT ha risolto il punto debole storico di Codex: la velocità. Claude ha fatto un salto reale sulla capacità e stabilità con contesti lunghi.
Spingono in direzioni diverse, e entrambe le direzioni fanno avanzare l'AI coding.
Non c'è un vincitore. C'è un ecosistema che migliora.