Teoria AI
Articoli educativi su LLM, architetture agent, prompt engineering e le tecnologie che alimentano gli strumenti di AI coding. Teoria spiegata per sviluppatori.
24 contenuti trovati
La prima risposta è lenta, le altre volano: cosa conserva davvero la KV cache
Per un modello da 13 miliardi di parametri la cache di un singolo token occupa 800 KB, e una richiesta da 2048 token arriva a 1,6 GB. Da quella memoria nasce lo sconto del 90% sul prompt caching, e anche la regola che quasi nessuno applica: la cache è un prefisso, e un byte cambiato in testa la butta via tutta.
Partire dal rumore: e se il codice non si scrivesse da sinistra a destra?
I modelli a diffusione partono da una tela di rumore e la raffinano tutta insieme, quindi possono tornare sui propri passi. Nel 2026 scrivono codice a oltre mille token al secondo. La tabella di Google dice anche quanto costa: perdono su tutti e quattro i benchmark contro il fratello autoregressivo.
«Aspetta, ricontrollo»: quando un modello ragiona davvero e quando recita
Nel ragionamento dei modelli c'è un punto dopo il quale la risposta non cambia più: su alcuni modelli arriva dopo il 13% del testo. Sulle domande facili il resto è teatro, sulle difficili no. E quando un'informazione arriva da un tool, il ragionamento tende a non dirlo.
Siamo in un esponenziale?
Tre curve esponenziali reali. Tre che non lo sono. La differenza tra fare il dev oggi con realismo o con hype.
Long-running agents: l'autonomia lunga è meno nuova (e più fragile) di come la raccontano
Anthropic dichiara agenti che girano per ore. Cognition parla di giorni. Il pattern in sé però ha 80 anni — cibernetica, servomeccanismi, planner anni '70. La novità è il controller. E con la novità arriva la fragilità.
Wiener aveva già scritto il manuale degli agenti nel 1948
Il loop sense→decide→act→feedback che chiamiamo 'agentic AI' è cibernetica del 1948. Cosa Wiener e Ashby avevano già capito, e cosa davvero è nuovo oggi.
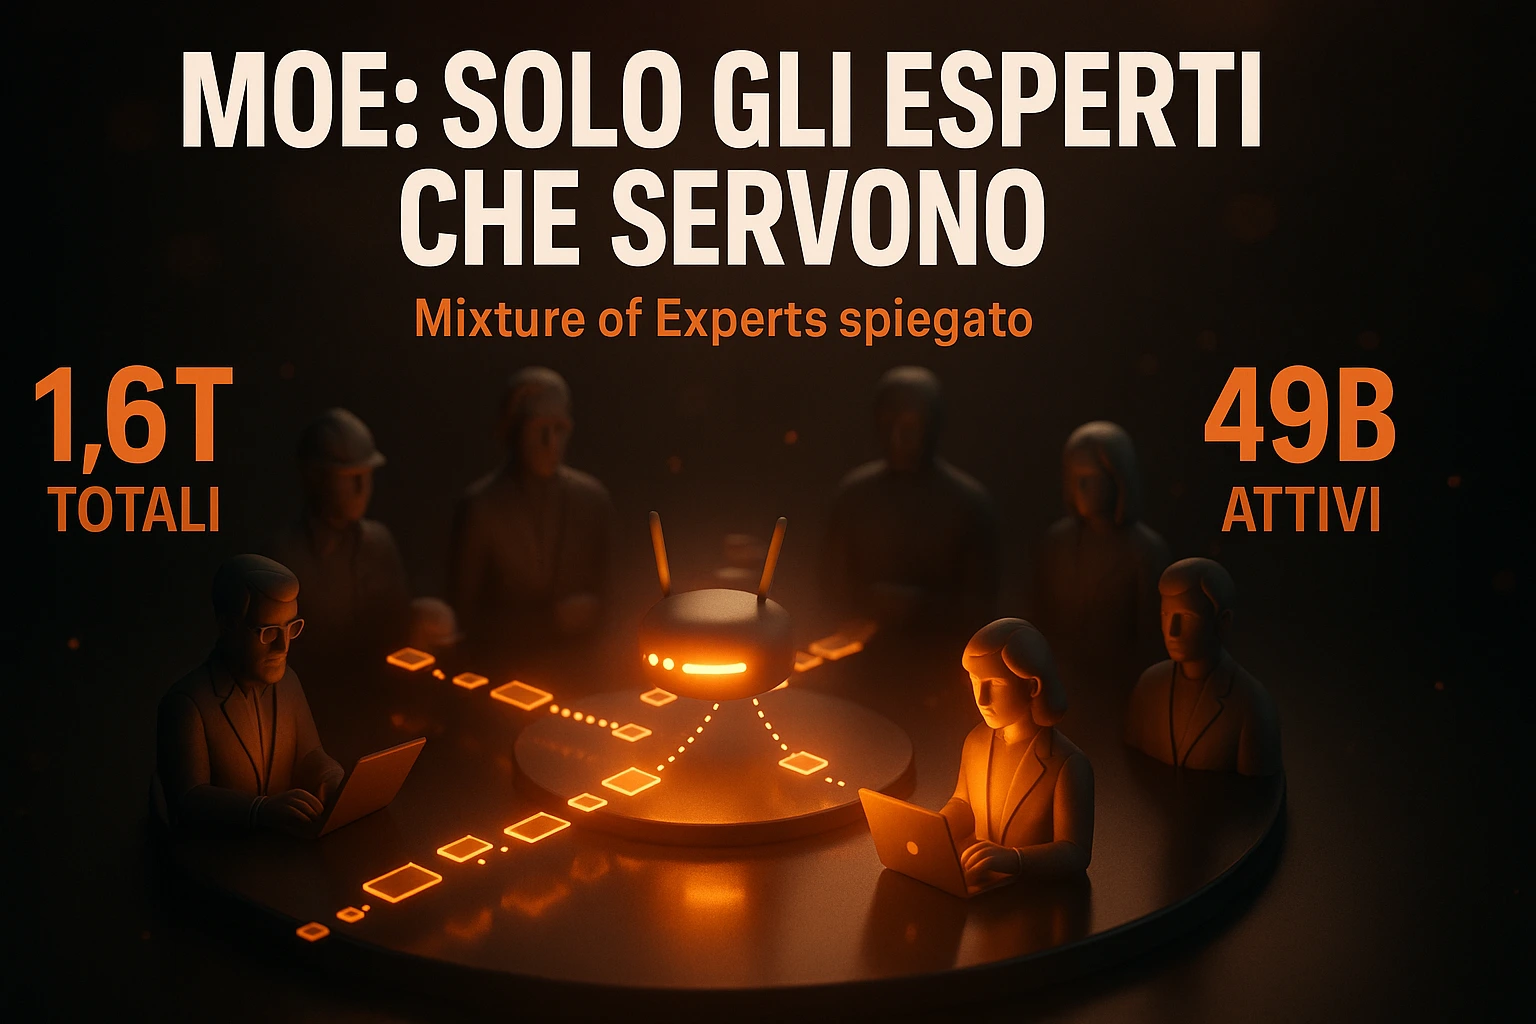
MoE: l'idea di attivare solo gli esperti che servono
Cos'è davvero un Mixture of Experts: router, top-k, active vs total. Da Jacobs/Hinton 1991 a DeepSeek V4-Pro, Mixtral, Qwen3 e Llama 4. Senza formule pesanti.
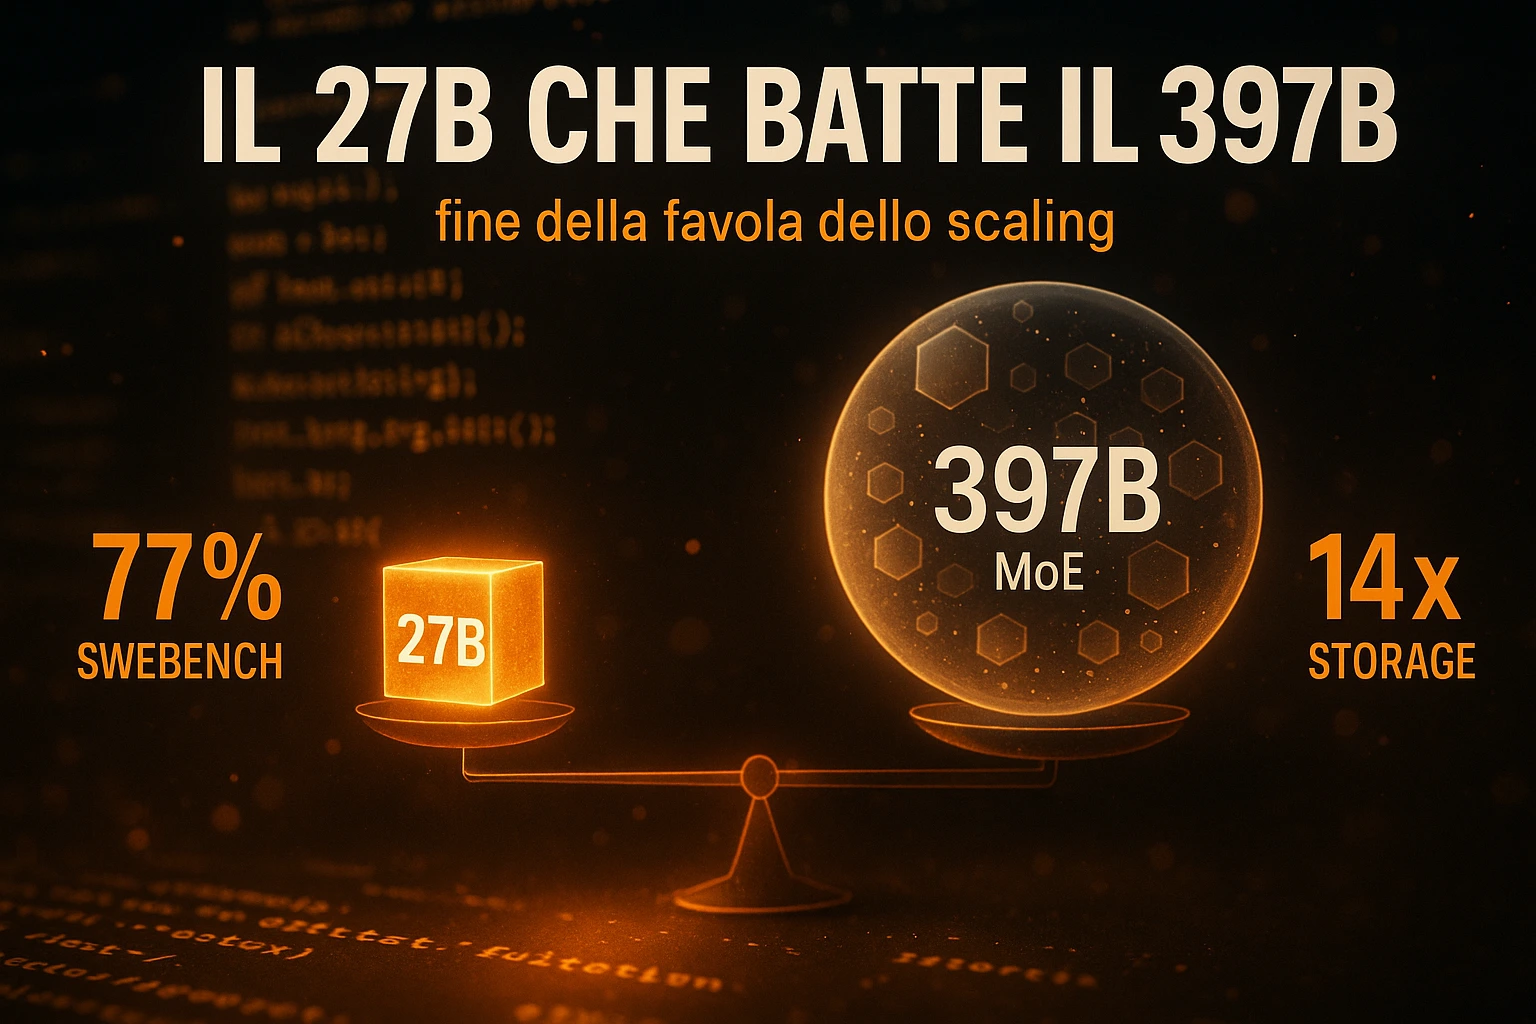
Il 27B che batte il 397B: fine della favola dello scaling
Qwen3.6-27B supera un MoE da 397B su benchmark di coding. Ma non è 15x meno parametri: è una storia di scaling laws, Chinchilla, Densing Law e — sorpresa — del fatto che RLVR funziona male su MoE.
Pre-training: Come un LLM Legge Internet e Impara a Parlare
Da 300B a 15T token. Da $900 a $191M. Il pre-training è la fase dove un LLM legge tutto internet e impara a prevedere la prossima parola. Ecco come funziona.