Harness Engineering: Come Controllare gli Agenti AI Senza Soffocarli
LangChain ha migliorato del 14% le performance di un agente senza cambiare modello: solo l'harness. Guida pratica alle 3 componenti che rendono gli agenti più capaci.
Alessandro Saiani
Human in the Loop
LangChain ha preso lo stesso identico modello -- GPT-5.2-Codex -- e ha cambiato solo l'infrastruttura intorno. Il punteggio su Terminal Bench 2.0 è passato dal 52.8% al 66.5%. Quattordici punti percentuali. Zero modifiche al modello.
Quel dato racconta una verita scomoda per chi passa settimane a scegliere quale LLM usare: l'harness conta più del modello. E la maggior parte di noi non ha ancora un harness degno di questo nome.
Il termine è esploso nelle ultime settimane. OpenAI lo ha coniato a febbraio, Martin Fowler lo ha legittimato, Anthropic ha pubblicato best practice concrete. Al QCon London di otto giorni fa, Birgitta Bockeler di Thoughtworks ha mostrato numeri che dovrebbero togliere il sonno a chi lancia agenti senza protezioni.
Questa guida smonta l'harness engineering pezzo per pezzo: cos'è, perché serve, e soprattutto cosa puoi fare domani mattina per implementarlo.
Cos'e l'Harness Engineering (e Cosa NON E)
Partiamo dalla definizione, perché la confusione in giro è tanta.
Birgitta Bockeler lo definisce come "the tooling and practices we can use to keep AI agents in check" -- ma aggiunge subito la parte che conta: "a good harness makes agents more capable, not just more controlled."
Questa seconda meta della frase è tutto. Non stiamo parlando di mettere guinzagli agli agenti. Stiamo parlando di costruire l'infrastruttura che permette loro di lavorare meglio, più a lungo, con meno errori.
La metafora originale viene dall'equitazione: redini, sella, morso -- l'equipaggiamento completo per guidare un animale potente ma imprevedibile nella direzione giusta. Non lo limiti. Lo indirizzi.
Cosa NON e
Non è prompt engineering. Il prompt engineering si occupa di come formuli una singola domanda per ottenere una buona risposta. E un singolo turno, un singolo messaggio.
Non è nemmeno solo context engineering, anche se lo include. Il context engineering si occupa di cosa vede l'agente -- quale documentazione, quali file, quale memoria. E un pezzo fondamentale, ma è un pezzo.
L'harness engineering è il sistema completo. Include il contesto, ma anche i vincoli architetturali, il monitoraggio, la sicurezza, la pulizia automatica. Pensa alla differenza così:
- Prompt engineering: come parli al modello
- Context engineering: cosa vede il modello
- Harness engineering: l'intero ambiente in cui il modello opera
O, come lo sintetizza un articolo su Substack: "Context engineering asks what should the agent see; harness engineering is about what should the system prevent, measure, and correct."
Un output sbagliato una volta? Probabilmente un problema di contesto. Un degrado lento su settimane? Quello è un problema di harness.
Le Tre Componenti: Il Framework Fowler-Bockeler
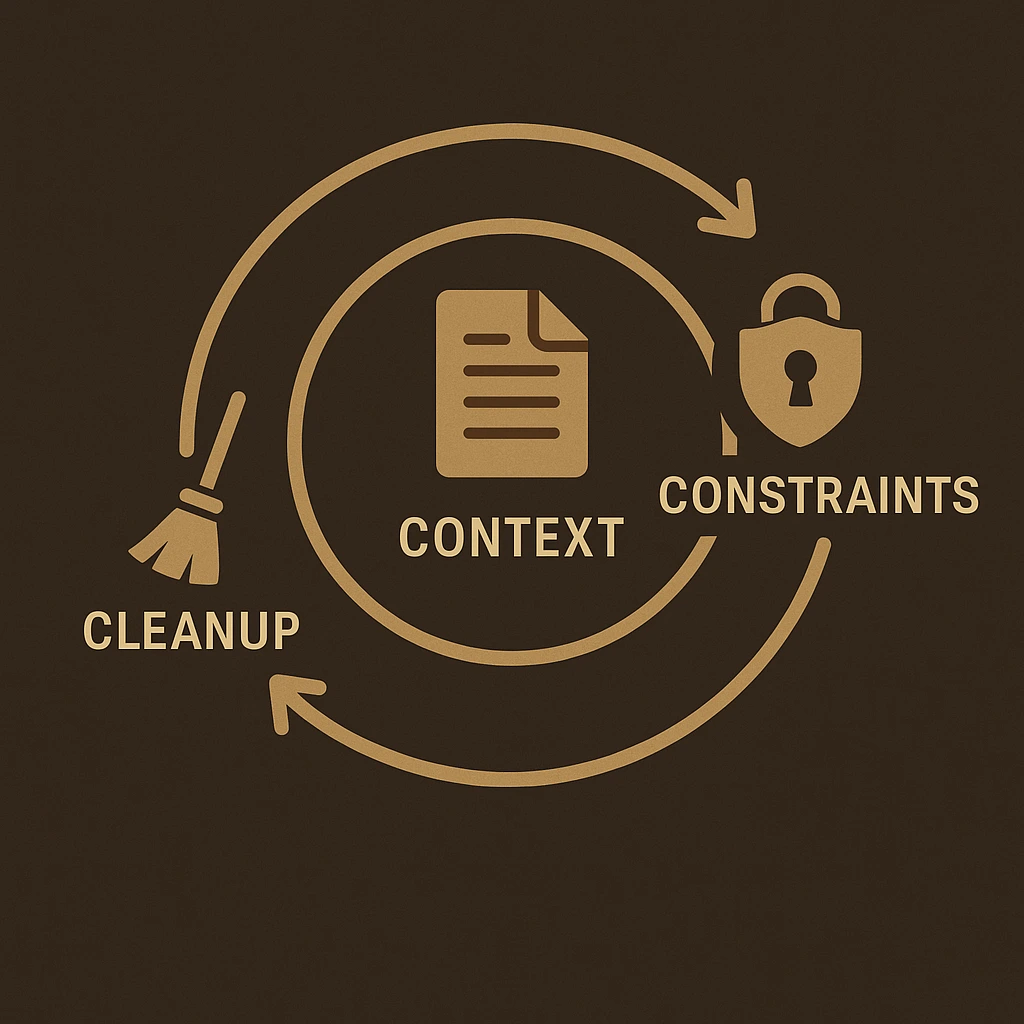
Birgitta Bockeler ha pubblicato sul blog di Martin Fowler un'analisi dell'esperimento OpenAI che identifica tre componenti dell'harness. È il framework più pulito che abbiamo, e vale la pena usarlo come mappa.
1. Context Engineering
La knowledge base continuamente migliorata nel codebase, più l'accesso dell'agente a contesto dinamico.
Ne abbiamo gia parlato in dettaglio nella guida pratica al context engineering. Il succo: CLAUDE.md, .cursorrules, AGENTS.md, MCP server. Tutto cio che l'agente vede quando inizia a lavorare.
Ma nel framework dell'harness, il context engineering ha una sfumatura diversa: non è statico. E un sistema che si auto-migliora. OpenAI lo descrive così: "When the agent struggles, they treat it as a signal: identify what is missing -- tools, guardrails, documentation -- and feed it back into the repository."
L'agente fatica? Non è un fallimento. È un segnale. Qualcosa manca nel contesto, e tu lo aggiungi. Il contesto migliora iterazione dopo iterazione.
2. Architectural Constraints
I vincoli architetturali sono la parte che distingue l'harness dal semplice context engineering. Non stai solo dicendo all'agente cosa fare -- stai rendendo impossibile fare certe cose sbagliate.
Concretamente:
- Pre-commit hooks che bloccano codice non conforme
- Linter personalizzati che verificano pattern architetturali
- Test strutturali (tipo ArchUnit) che impediscono violazioni dei layer
- Sandbox con allow-listing dei comandi eseguibili
- Isolamento di rete per ambienti di esecuzione
Il punto chiave, citando Fowler: "Increasing trust and reliability required constraining the solution space: specific architectural patterns, enforced boundaries, standardized structures."
Per fidarti di più dell'agente, devi dargli meno libertà. Non è un paradosso -- è design.
3. Garbage Collection
La componente che nessuno vuole implementare è che fa la differenza più grande su tempi lunghi.
Agenti periodici che passano il codebase e trovano inconsistenze nella documentazione, violazioni dei vincoli architetturali, drift tra codice e specifiche. È la pulizia automatica del debito che gli agenti accumulano lavorando.
Senza garbage collection, ogni sessione agente lascia un po' di entropia. Dopo settimane, l'entropia diventa debito tecnico ingestibile. Con la garbage collection, il codebase si auto-ripara.
Il Costo di NON Farlo
Al QCon London del 16 marzo, Birgitta Bockeler ha messo sul tavolo numeri che meritano attenzione.
Un agente AI nel 2026 costa circa $380 al giorno. Fanno $91.200 l'anno -- lo stipendio di uno sviluppatore solido in Germania. Nel 2024 si parlava di $0.12 per 100 righe di codice. In due anni il costo si è moltiplicato di ordini di grandezza, perché siamo passati da suggerimenti inline ad agenti autonomi che girano per 20 minuti senza supervisione.
Ma il costo vero non è il prezzo dell'API. E quello che succede quando l'agente sbaglia senza che nessuno se ne accorga.
Bockeler riporta incidenti di prompt injection con cadenza settimanale nei team Thoughtworks. Undici giorni prima del talk, un attaccante ha usato un GitHub issue costruito ad arte per sfruttare un agente non supervisionato: ha estratto segreti e pubblicato pacchetti NPM malevoli.
Non è teoria. E cronaca.
Il framework di rischio che propone ha tre variabili:
| Variabile | Domanda |
|---|---|
| Probabilita di errore | Quanto spesso l'agente sbaglia su questo tipo di task? |
| Impatto dell'errore | Cosa succede se sbaglia? |
| Rilevabilità dell'errore | Quanto è facile accorgersi che ha sbagliato? |
Quando tutte e tre sono alte -- alta probabilità, alto impatto, bassa rilevabilità -- sei nel territorio del disastro. È senza un harness, ci sei più spesso di quanto pensi.
Context Engineering nell'Harness: Oltre il CLAUDE.md
Se hai seguito la nostra guida al context engineering pratico, hai gia la base. Ma nell'ottica dell'harness, il contesto ha regole più stringenti.
La regola delle 60 righe
HumanLayer consiglia di mantenere CLAUDE.md e AGENTS.md sotto le 60 righe. È più restrittivo del limite di 150-200 istruzioni che cita Anthropic, e c'è un motivo: nell'harness engineering, il contesto statico deve essere chirurgico. Ogni riga superflua ruba spazio al contesto dinamico che l'agente accumula lavorando.
Birgitta Bockeler lo conferma con un dato: il 15% della context window è già consumato prima del primo prompt dell'utente. System prompt, definizioni tool, rules file -- tutto questo mangia contesto prima ancora che tu dica "ciao".
Progressive disclosure
La soluzione non è scrivere meno. E scrivere in modo stratificato.
LangChain lo chiama "skills con progressive disclosure": le informazioni dettagliate non vengono caricate all'inizio. Vengono iniettate quando servono, in base al task corrente. Come descrivevamo nell'articolo sulle skill AI condivise, le skill generiche non funzionano -- e nell'harness engineering questo principio diventa strutturale.
In pratica:
CLAUDE.md (caricato sempre):
  - Stack, comandi, convenzioni critiche (30-40 righe)

.claude/rules/database.md (caricato on-demand):
  - Schema, migration, query patterns

.claude/rules/security.md (caricato on-demand):
  - Policy di sicurezza, gestione segreti, validazione input
L'agente parte leggero. Carica il dettaglio solo quando ne ha bisogno.
Lo studio ETH Zurich: attenzione ai file AI-generated
Un dato che dovrebbe far riflettere chiunque faccia generare il proprio CLAUDE.md all'AI: uno studio ETH Zurich su 138 task Python reali ha mostrato che i file di contesto generati da LLM peggiorano la performance del 3% e aumentano i costi di inferenza del 20%+.
File scritti da umani? Miglioramento marginale del 4%, con aumento dei costi del 19%.
Il punto è che i file AI-generated tendono a duplicare informazione già presente nel codebase. Quando i ricercatori hanno rimosso README e docs esistenti, i file LLM-generated hanno migliorato del 2.7% -- dimostrando che aggiungono valore solo quando colmano un vuoto informativo.
La raccomandazione: limita le istruzioni a dettagli che l'agente non può inferire dal codice. Tooling specifico, comandi di build custom, convenzioni che rompono cose se ignorate. Tutto il resto è rumore.
Architectural Constraints: Il Sandbox che Libera
Sembra controintuitivo, ma vincolare l'agente lo rende più efficace. Ridurre lo spazio delle soluzioni significa meno esplorazione casuale, meno errori, più consistenza.
Git Worktree e Branch Isolati
Ogni sessione agente dovrebbe operare su un branch dedicato. Meglio ancora: un git worktree separato. Così l'agente lavora in una copia isolata del repo, e le sue modifiche non toccano il branch principale finché non passano la review.
# Crea un worktree isolato per l'agente
git worktree add ../agent-feature-x -b feature/agent-task-x

# L'agente lavora in ../agent-feature-x
# Le modifiche restano isolate fino al merge
Anthropic usa questo pattern per gli agenti di lunga durata: commit puliti tra le sessioni, messaggi descrittivi, una feature per sessione.
Layer Enforcement
L'esperimento OpenAI definisce layer di dipendenza espliciti:
Types -> Config -> Repo -> Service -> Runtime -> UI
Un layer può dipendere solo dai layer alla sua sinistra. Mai al contrario. Questa regola viene enforced da test strutturali automatici -- non da istruzioni nel prompt.
La differenza è fondamentale: un'istruzione nel prompt può essere ignorata. Un test che fallisce blocca il merge.
Sandbox e Allow-Listing
L'agente non dovrebbe avere accesso a tutto. LangChain descrive ambienti sandboxed con:
- Allow-listing dei comandi: l'agente può eseguire solo comandi esplicitamente autorizzati
- Isolamento di rete: nessun accesso a internet non necessario
- Filesystem limitato: accesso solo alle directory del progetto
Non è sfiducia. E buon senso. Lo stesso motivo per cui i server di produzione non danno l'accesso root a tutti.
Checkpoint System
Anthropic descrive un sistema di checkpoint per agenti di lunga durata. Due componenti:
- Initializer Agent: configura l'ambiente, scrive un
init.sh, crea il primo commit, produce unclaude-progress.txt - Coding Agent: lavora in sessioni discrete, aggiorna il progresso, committa tra le sessioni
L'analogia è perfetta: "Engineers working in shifts, where each new engineer arrives with no memory of what happened." Il checkpoint è l'unico modo per mantenere continuità.
Come descritto nell'articolo su Karpathy e gli agenti che lavorano 16 ore, il pattern di sessioni brevi con handoff strutturato è quello che separa chi ottiene risultati da chi accumula caos.
Garbage Collection: Pulire Dopo l'Agente
È la componente più trascurata e forse la più importante per chi lavora con agenti su tempi lunghi.
Il problema dell'entropia
Ogni sessione agente lascia tracce: commenti TODO dimenticati, documentazione non aggiornata, codice morto, inconsistenze tra moduli. Su una singola sessione il danno è trascurabile. Su settimane di lavoro con agenti multipli, l'entropia si accumula fino a rendere il codebase ingestibile.
Compaction e Summarization
LangChain descrive due tecniche per gestire il contesto che cresce:
- Compaction: quando il contesto si avvicina ai limiti, viene riassunto automaticamente. Le informazioni recenti restano intatte, quelle vecchie vengono compresse
- Tool output offloading: output grandi (log, dump di database, tracce di errore) vengono scaricati su filesystem invece di restare nella context window
Agenti di pulizia
Il pattern più avanzato prevede agenti dedicati alla manutenzione:
- Un agente che verifica la coerenza tra codice e documentazione
- Un agente che cerca violazioni dei vincoli architetturali
- Un agente che identifica codice duplicato o pattern inconsistenti
Non sono agenti che scrivono feature. Sono agenti che mantengono l'igiene del codebase. Sono la garbage collection del vostro sistema.
OpenAI li chiama esplicitamente parte dell'harness: "Documentazione cross-linked validata meccanicamente tramite linter e CI."
Loop Detection
LangChain introduce un middleware specifico per prevenire i "doom loop" -- situazioni in cui l'agente ripete lo stesso approccio fallito all'infinito. Il middleware traccia le modifiche ai file e interviene quando rileva pattern circolari.
Se hai mai visto un agente tentare la stessa fix 5 volte di fila, sai quanto vale questo componente.
Sicurezza: La Lethal Trifecta
Simon Willison ha identificato una combinazione letale che ogni harness deve prevenire. La chiama "Lethal Trifecta" e si verifica quando tre condizioni coesistono:
- Esposizione a contenuto non fidato: l'agente processa testo controllato dall'attaccante (issue GitHub, email, commenti)
- Accesso a dati privati: l'agente può leggere segreti, credenziali, dati sensibili
- Capacita di comunicare esternamente: l'agente può inviare dati fuori dal sistema (email, API call, push su registry)
Quando le tre condizioni si combinano, un prompt injection può trasformare il tuo agente in un vettore di attacco. Non è fantascienza -- è già successo.
Gli incidenti reali del 2026
Clinejection (febbraio 2026): un prompt injection nascosto nel titolo di un GitHub issue ha compromesso la supply chain NPM. Circa 4.000 macchine sviluppatore infettate. L'agente ha letto l'input non fidato, eseguito comandi arbitrari, rubato segreti di produzione per pubblicare pacchetti malevoli.
RoguePilot (febbraio 2026): istruzioni nascoste in commenti HTML di GitHub issue, processate automaticamente da Copilot in GitHub Codespaces, hanno causato l'esfiltrazione del GITHUB_TOKEN. Risultato: takeover del repository.
ToxicSkills (Snyk, febbraio 2026): analisi di 3.984 skill da piattaforme pubbliche. Il 36% (1.467 skill) presenta almeno un problema di sicurezza. 76 payload confermati come malevoli, progettati per furto credenziali, installazione backdoor ed esfiltrazione dati. Le submission giornaliere sono passate da meno di 50 a oltre 500 in poche settimane.
Come difendersi
La risposta di Willison e netta: i prodotti "guardrail" che affermano di prevenire il 95% degli attacchi non sono affidabili. Gli LLM non distinguono l'importanza delle istruzioni in base alla provenienza. Non puoi fidarti della detection. Devi evitare la combinazione.
In pratica:
| Principio | Implementazione |
|---|---|
| Minimizza l'input non fidato | Non far processare all'agente issue/email/commenti esterni senza sanitizzazione |
| Limita l'accesso ai segreti | L'agente non dovrebbe MAI vedere credenziali o token in chiaro. Usa variable d'ambiente isolate |
| Blocca le comunicazioni esterne | Sandbox di rete. L'agente non pubblica su registry, non invia email, non fa push senza approvazione umana |
| Human-in-the-loop per azioni irreversibili | Qualsiasi operazione che modifica stato esterno (deploy, publish, invio) richiede approvazione |
Come dice Bockeler: "Security is not a technical problem; it's a conceptual problem." Non è una questione di tool migliori. E una questione di design del sistema.
Il Dato LangChain: L'Harness Conta Piu del Modello
Vale la pena tornare sul dato più importante di tutta la ricerca, perché cambia le priorita di investimento.
LangChain ha preso il suo agente è lo ha ottimizzato solo a livello di harness -- stesso modello, stesso dataset, stesso benchmark. Tre aree di intervento:
1. System Prompt
Non il prompt dell'utente -- il system prompt del framework. Ottimizzato per dare all'agente consapevolezza dell'ambiente: struttura directory, tool disponibili, budget di tempo.
2. Tools
I tool a disposizione dell'agente. Non più tool, ma tool migliori. Piu mirati, con output più puliti, meno rumore nella context window.
3. Middleware
Tre middleware specifici:
- Self-Verification Loop: ciclo build-verify-fix con testing e cross-checking contro le specifiche del task
- LocalContextMiddleware: inietta consapevolezza dell'ambiente
- Loop Detection: previene i doom loop
Il middleware più impattante è il Self-Verification Loop. L'agente non si limita a generare codice -- genera, testa, verifica contro le specifiche, e itera se qualcosa non torna. E il testing automatizzato integrato nel loop dell'agente.
Risultato: dal 52.8% al 66.5% su Terminal Bench 2.0. Da Top 30 a Top 5 nella classifica. Stesso modello.
Chi nella tua organizzazione investe settimane a fare benchmark di modelli LLM probabilmente otterrebbe risultati migliori investendo quelle settimane sull'harness.
L'Esperimento OpenAI: 1 Milione di Righe, Zero Codice Manuale
Il case study più ambizioso sull'harness engineering viene da OpenAI stessa. Tre ingegneri, cinque mesi, una regola: nessun codice scritto manualmente. Solo Codex.
Il risultato: un prodotto beta funzionante con oltre 1 milione di righe di codice. Logica applicativa, documentazione, configurazione CI, setup observability, tooling -- tutto generato da agenti.
Ma il punto non è il milione di righe. E il principio che ha guidato tutto: "When the agent struggles, they treat it as a signal."
Ogni volta che Codex faticava su un task, i tre ingegneri non lo risolvevano manualmente. Identificavano cosa mancava -- tool, guardrail, documentazione -- è lo aggiungevano al repository. Facendo scrivere la fix a Codex stesso.
E un feedback loop potente: l'harness migliora a ogni fallimento dell'agente. Il fallimento è il motore del miglioramento, non un problema da aggirare.
Le componenti concrete del loro harness:
- Pre-commit hooks per ogni merge
- Linter personalizzati per pattern architetturali
- ArchUnit per test strutturali
- Layer di dipendenza enforced (Types -> Config -> Repo -> Service -> Runtime -> UI)
- Documentazione cross-linked validata meccanicamente
- Prompts dichiarativi anziche script handcrafted
Come scrivevamo nell'articolo sull'agentic engineering, il 70% del lavoro sta nella definizione del problema e dei vincoli. L'esperimento OpenAI è la dimostrazione empirica che quel 70% produce risultati su scala industriale.
Le Istruzioni AI-Generated Peggiorano le Cose
Lo studio ETH Zurich merita una sezione a parte perché demolisce un pattern diffusissimo: far generare il CLAUDE.md all'AI.
Su 138 task Python reali (dataset AGENTbench, repository di nicchia), i file di contesto generati da LLM:
- Peggiorano la performance del 3%
- Aumentano i costi di inferenza del 20%+
Perche? Perché duplicano informazione già presente nel codebase. L'agente si ritrova a processare due volte le stesse informazioni -- una nel codice, una nelle istruzioni -- sprecando contesto e introducendo potenziali contraddizioni.
I file scritti da umani fanno leggermente meglio (+4%), ma il costo-beneficio e comunque discutibile (+19% costi).
La lezione e chiara: le istruzioni nel rules file devono contenere solo cio che l'agente non può dedurre dal codice. Comandi di build non ovvi, convenzioni che causano bug se ignorate, workaround per problemi noti. Tutto il resto -- lo stile del codice, la struttura dei file, i pattern architetturali -- l'agente lo impara dal codebase.
E un principio che avevamo gia esplorato nella guida al context engineering pratico: ogni token nel rules file deve guadagnarsi il suo posto.
Cosa Fare Domani: La Checklist
L'harness engineering non si implementa in un giorno. Ma puoi iniziare domani con azioni concrete e iterare da li.
Settimana 1: Le Basi
- Rivedi il tuo rules file -- taglia tutto cio che l'agente può dedurre dal codice. Obiettivo: sotto 60 righe
- Aggiungi pre-commit hooks -- almeno linting e formatting automatici. L'agente non deve poter committare codice che non passa i controlli base
- Isola le sessioni agente -- un branch o worktree per sessione. Mai lavorare direttamente su main
- Attiva il checkpoint --
claude-progress.txto equivalente. Ogni sessione deve lasciare traccia strutturata
Settimana 2: Sicurezza
- Verifica la Lethal Trifecta -- il tuo agente ha accesso a input non fidato + dati sensibili + comunicazioni esterne? Se si, chiudi almeno un lato del triangolo
- Audita le skill/MCP -- stai usando skill di terze parti? Verifica la provenienza. Il 13.4% ha problemi di sicurezza
- Human-in-the-loop per azioni irreversibili -- deploy, publish, invio email: niente di automatico senza approvazione
Settimana 3: Vincoli Architetturali
- Definisci i layer -- quali moduli possono dipendere da quali? Scrivilo, poi enforcea con test
- Aggiungi test strutturali -- ArchUnit, eslint rules custom, o anche solo script bash che verificano i pattern
- Configura il sandbox -- limita i comandi eseguibili dall'agente. Allow-list, non block-list
Settimana 4: Garbage Collection
- Crea un agente di pulizia -- un prompt che gira periodicamente e verifica coerenza tra codice e documentazione
- Attiva loop detection -- monitora quando l'agente ripete le stesse modifiche. Puo essere semplice come un hook che confronta le ultime N diff
- Misura il contesto -- quanto della context window e consumato prima del primo prompt? Se sei sopra il 20%, hai un problema
Ongoing
- Tratta ogni fallimento dell'agente come un segnale -- non risolvere manualmente. Identifica cosa manca nell'harness e aggiungilo
- Rivedi il rules file ogni settimana -- togli le regole che l'agente segue gia da solo, aggiungi quelle che servono
- Monitora i costi -- $380/giorno è il benchmark. Sai quanto spendi?
L'Harness Come Conoscenza Istituzionale
C'e un effetto collaterale dell'harness engineering che nessuno menziona ma che potrebbe essere il più prezioso di tutti.
Quando costruisci un harness -- rules file, test strutturali, linter personalizzati, agenti di pulizia, documentazione validata meccanicamente -- stai documentando la conoscenza istituzionale del team in formato machine-readable.
Quel CLAUDE.md snello di 60 righe? Sono le 60 cose più importanti da sapere sul progetto. Quei test strutturali? Sono le decisioni architetturali cristallizzate in codice. Quei pre-commit hooks? Sono gli errori che il team ha gia fatto e ha deciso di non ripetere.
E tutto questo funziona sia per gli agenti AI che per gli sviluppatori umani che entrano nel team. L'harness è il miglior documento di onboarding che possiate avere, perché e sempre aggiornato -- se non lo fosse, gli agenti smetterebbero di funzionare.
La disciplina di mantenere l'harness in ordine costringe il team a rendere esplicito cio che di solito resta implicito. E quello e oro, indipendentemente dall'AI.
L'harness engineering non è un costo. E un investimento in infrastruttura che paga dividendi sia con gli agenti che senza.
Chi inizia adesso, prima che il codebase diventi ingestibile, avra un vantaggio competitivo nei prossimi mesi. Chi aspetta, paghera il prezzo in entropia accumulata -- e i $380 al giorno saranno spesi molto peggio.
Fonti:
- InfoQ - State of Play: AI Coding Assistants (QCon London 2026)
- The Register - AI for software developers is in a 'dangerous state' (QCon London)
- Martin Fowler / Birgitta Bockeler - Harness Engineering
- OpenAI - Harness Engineering: Leveraging Codex in an Agent-First World
- LangChain - The Anatomy of an Agent Harness
- LangChain - Improving Deep Agents with Harness Engineering
- Anthropic - Effective Harnesses for Long-Running Agents
- Simon Willison - The Lethal Trifecta
- HumanLayer - Skill Issue: Harness Engineering for Coding Agents
- Snyk - ToxicSkills: Malicious AI Agent Skills on ClawHub