Context Engineering: Cosa Vede l'AI Quando Scrivi Codice
L'AI non vede tutto il tuo progetto. Come funzionano Claude Code, Codex, Cursor e Gemini CLI sotto il cofano. I dati reali sulla context pollution.
Alessandro Saiani
Human in the Loop
"Ma il mio progetto lo vede tutto?"
È la domanda che mi fanno più spesso. E la risposta è: no. Non lo vede tutto. Non lo ha mai visto tutto. E capire questo cambia il modo in cui usi qualsiasi tool di AI coding.
Andrej Karpathy — quello che ha guidato il team AI di Tesla e co-fondato OpenAI — ha dato forse la definizione più chiara: l'LLM è una CPU, la context window è la RAM. Tu, lo sviluppatore (o il tool che usi), sei il sistema operativo che decide cosa caricare in memoria.
Il termine context engineering nasce proprio qui. Non è prompt engineering — quello è scrivere bene una domanda. Context engineering è decidere cosa far vedere all'AI prima che le fai la domanda. È il lavoro invisibile che determina se l'AI ti dà una risposta brillante o un'allucinazione.
Tobi Lütke, CEO di Shopify, l'ha detto in modo diretto: "Mi piace il termine context engineering più di prompt engineering. Descrive meglio la skill reale: l'arte di fornire tutto il contesto necessario perché il task sia risolvibile dall'LLM."
E Simon Willison ha spiegato perché il termine resterà: a differenza di "prompt engineering", la cui definizione percepita dalla maggior parte delle persone è "un termine ridicolmente pretenzioso per digitare cose in un chatbot", context engineering comunica immediatamente il lavoro reale che c'è dietro.
La Context Window: Quanto È Grande "la RAM"
Partiamo dai numeri, perché contano.
| Modello | Context Window | Equivalente approssimativo |
|---|---|---|
| GPT-5.3 Codex | 200K token | ~150.000 parole / ~500 pagine |
| Claude Opus 4.6 | 200K token | ~150.000 parole / ~500 pagine |
| Gemini 3 Pro | 1M token | ~750.000 parole / ~2.500 pagine |
Sembra tanto, vero? 500 pagine. Il problema è che quei token non sono tutti per i tuoi file. E — spoiler — la finestra "effettiva" è molto più piccola di quella pubblicizzata.
Una nota sui modelli "Codex": non è solo una questione di versione. GPT-5.3 Codex non è un GPT-5.3 generico — è specificamente fine-tuned per il coding agentico: leggere log di compilatori, interpretare stack trace, navigare codebase grandi. Le performance reali dipendono da quanto il modello è stato addestrato su quei task specifici, non solo dalla dimensione della finestra.
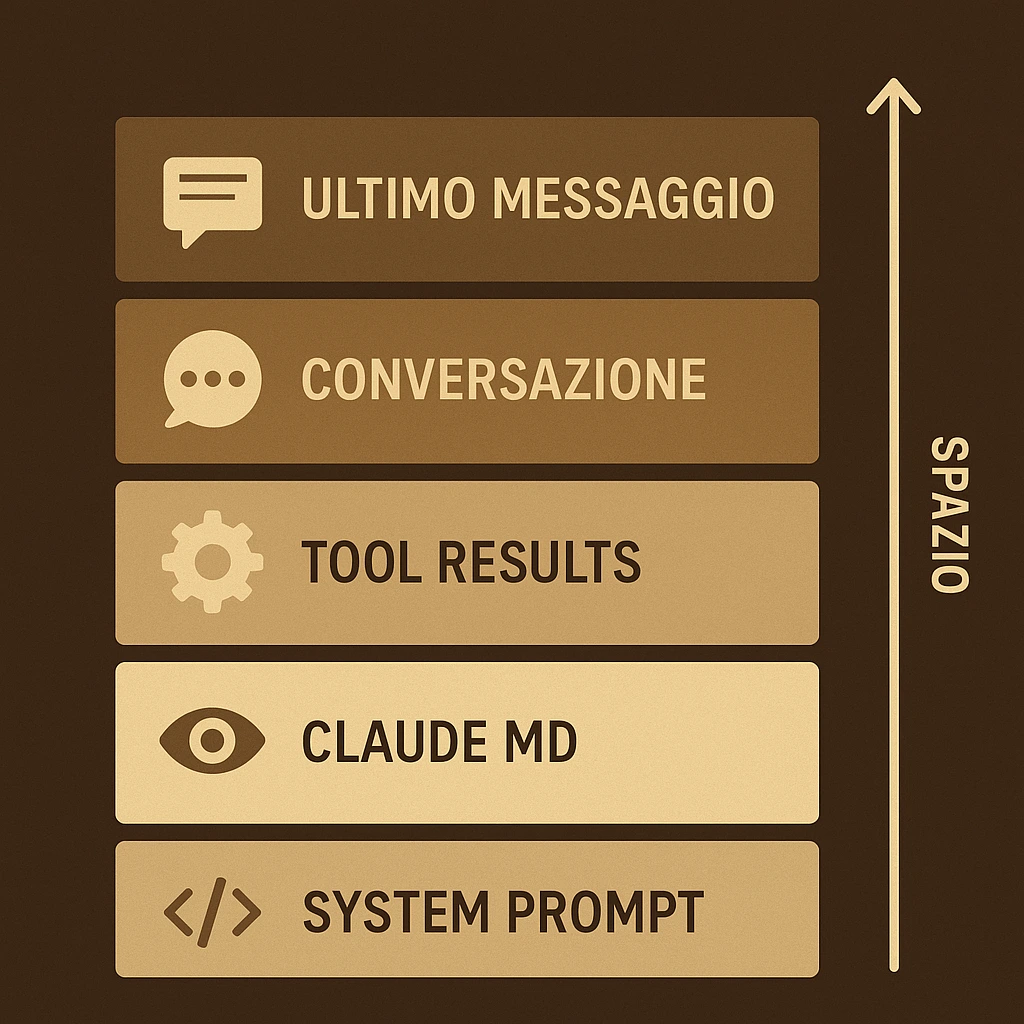
Cosa occupa spazio nella finestra
Immagina la context window come una stanza. Prima ancora che tu dica qualcosa, la stanza è già mezza piena:
- System prompt — Le istruzioni di base del modello. Nei tool come Claude Code, questo include le regole su come usare ogni tool disponibile, come comportarsi, le policy di sicurezza. Può occupare migliaia di token solo questo. E non è un segreto: esiste un repository su GitHub che raccoglie i system prompt estratti dai principali tool AI. Leggendoli capisci quanto spazio occupano e quanto condizionano il comportamento del modello prima ancora che tu scriva una parola.
- Istruzioni del progetto — Il file CLAUDE.md, .cursorrules, GEMINI.md, AGENTS.md... ogni tool ha il suo, ma il concetto è lo stesso: un file che descrive le convenzioni del tuo progetto, lo stack, i comandi. Alcuni progetti usano anche un generico
AGENTS.mdper istruzioni indipendenti dal tool. Altre centinaia o migliaia di token. - Cronologia della conversazione — Tutto quello che ti sei detto finora in questa sessione. Ogni messaggio, ogni risposta, ogni risultato di tool. Questo cresce rapidamente.
- Risultati dei tool — Quando l'AI legge un file, il contenuto di quel file entra nella finestra. Quando fa una ricerca, i risultati entrano nella finestra. Quando esegue un comando, l'output entra nella finestra.
- Il tuo messaggio — La tua richiesta attuale. Spesso la parte più piccola.
Il risultato? Su una context window da 200K token, dopo 15-20 minuti di lavoro intenso potresti averne già usati 180K solo di cronologia e risultati di tool. E quei 20K rimasti devono bastare per la risposta.
"Ma i File Li Carica Tutti Interi?"
Risposta breve: no, nessun tool li carica tutti. Ma il modo in cui scelgono cosa caricare è radicalmente diverso da tool a tool. Ed è qui che le cose si fanno interessanti.
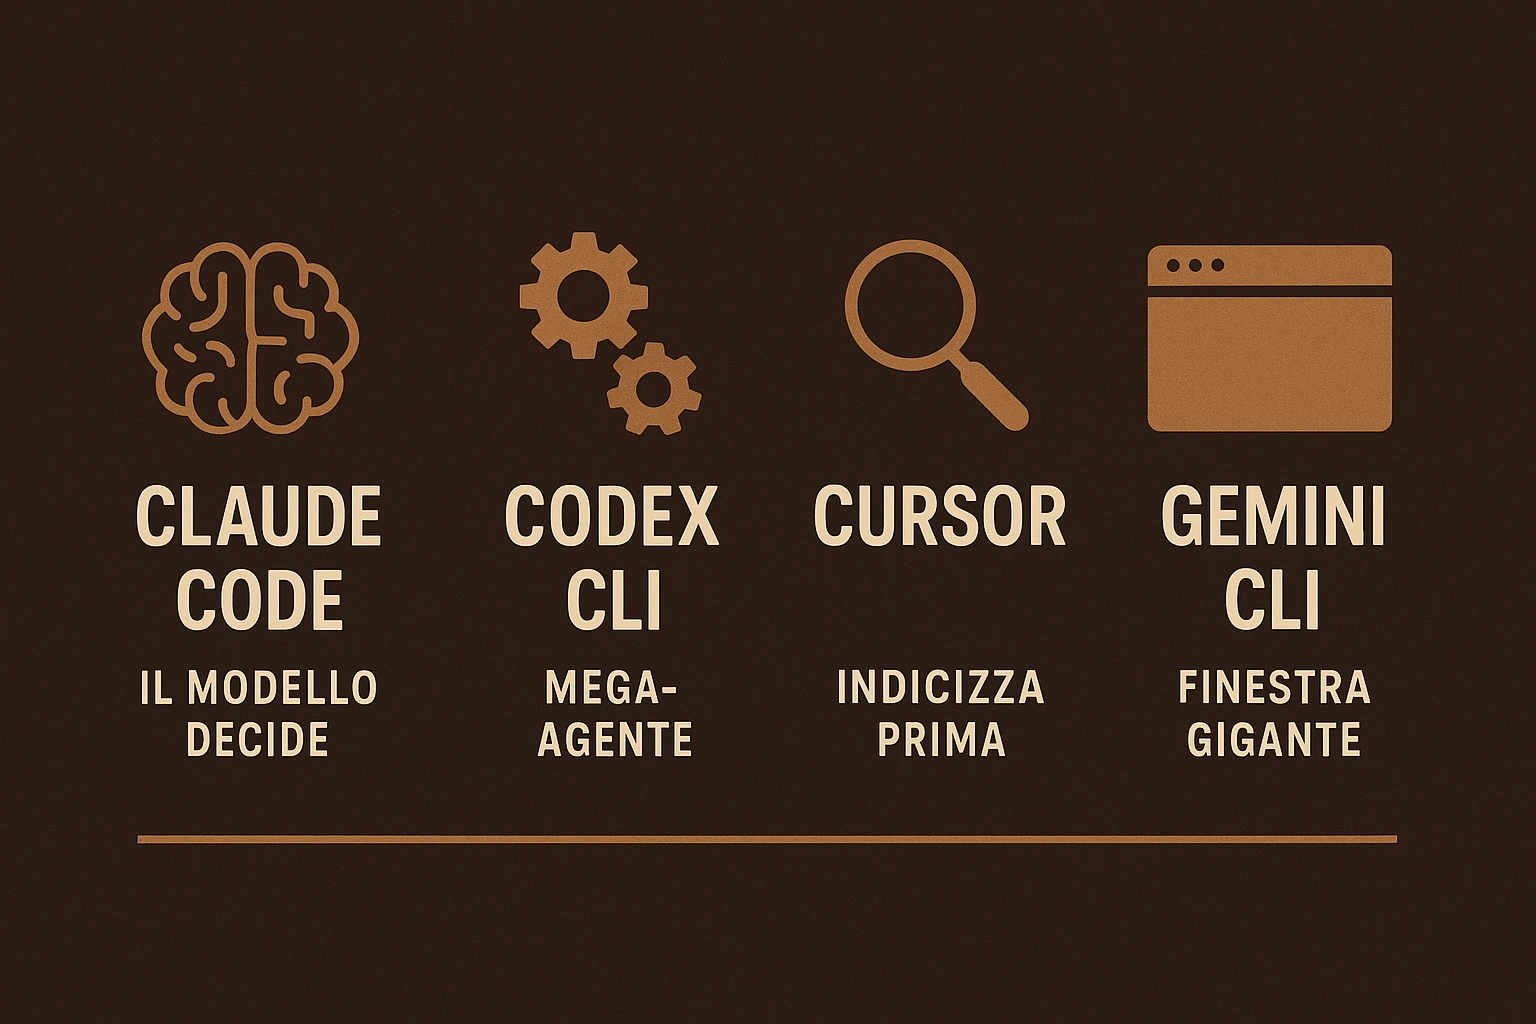
Quattro Filosofie, Quattro Architetture
Oggi i tool di AI coding dominanti seguono quattro approcci architetturali diversi per gestire il contesto. Capire le differenze spiega perché lo stesso prompt produce risultati diversi in tool diversi.
Claude Code: L'Esploratore
Claude Code è l'agente CLI di Anthropic. Non indicizza nulla. Non ha embedding. Non ha vector database.
Funziona come uno sviluppatore che apre terminale e IDE:
- All'avvio carica il system prompt (come usare i tool) e il CLAUDE.md del progetto
- Per ogni richiesta, l'agente decide autonomamente quali file leggere, usando tool come
Read(leggi un file),Glob(cerca per nome),Grep(cerca nel contenuto) - Può delegare ricerche a sub-agent con contesti separati (Explore per cercare nel codebase, Plan per progettare)
- Compatta automaticamente al 95% della capacità
File grandi: li legge a pezzi, specificando offset e limite di righe (es. prime 2.000 righe, poi le successive).
La filosofia: il modello è abbastanza intelligente da sapere cosa cercare. Niente indicizzazione preventiva, solo tool call on-demand.
Il trade-off: ogni file letto occupa token nella finestra. Se l'agente legge 15 file per capire un problema, quei 15 file restano tutti in memoria. La finestra si riempie velocemente su task complessi.
Codex CLI: Il Mega-Agente
Codex CLI è il tool open source di OpenAI, scritto in Rust. Ha una filosofia simile a Claude Code — nessun indice, nessun embedding — ma con differenze architetturali importanti.
OpenAI ha dichiarato esplicitamente la scelta: "Abbiamo compresso un fragile sistema multi-agente in un singolo mega-agente con 20+ tool."
I tool principali:
read_fileper leggere filerg(ripgrep) per cercare nel codebaseglob_file_searchper trovare fileapply_patchper modifiche strutturate (usa tree-sitter per il parsing)exec_commandper comandi shell in un terminale sandboxato
La differenza chiave: compaction addestrata nel modello. I modelli GPT-5.x-Codex non usano solo un prompt di riassunto generico — sono stati specificamente addestrati per compattare il proprio contesto. GPT-5.1-Codex-Max è progettato per sessioni di 24+ ore grazie a compattazione multi-finestra.
Come compatta: al 95% della capacità, riassume la cronologia preservando gli ultimi ~20K token di contesto recente. Il sistema è stato riscritto tra le versioni 0.54 e 0.56 perché il vecchio approccio creava "riassunti di riassunti" che degradavano rapidamente.
Niente sub-agent: a differenza di Claude Code, Codex CLI è un singolo agente con molti tool. La scommessa è che un agente potente con più tool sia meglio di un'orchestra di agenti specializzati.
Sandbox serio: isolamento a livello di sistema operativo — Landlock + Seccomp su Linux, Seatbelt su macOS, restricted token su Windows.
Cursor: L'Indicizzatore
Cursor è il caso più sofisticato e architetturalmente diverso. È l'unico dei quattro che pre-indicizza il tuo codebase.
Come funziona l'indicizzazione (step by step):
- Merkle Tree: all'apertura del progetto, Cursor calcola un hash per ogni file e li organizza in un albero. Questo permette di rilevare modifiche in O(log n) — se cambi un file, solo gli hash lungo il percorso fino alla radice cambiano
- Chunking AST: usa tree-sitter per dividere il codice ai confini semantici (dichiarazioni di funzione, classi, interfacce), non per numero di token
- Embedding: il codice viene processato dal modello di embedding proprietario di Cursor e i vettori vanno su Turbopuffer (il loro vector database). Ogni codebase è un namespace separato
- Sync incrementale: ogni 10 minuti, confronta gli hash del Merkle tree. Solo i file modificati vengono ri-embedati
Quando usi @codebase in una query, scatta una pipeline RAG completa:
- HyDE (Hypothetical Document Embedding): un LLM genera una risposta ipotetica alla tua domanda. L'intuizione è che l'embedding di una risposta ipotetica sarà più vicino nel vector space al codice rilevante rispetto alla domanda in linguaggio naturale
- Ricerca vettoriale su Turbopuffer
- Retrieval locale: Cursor legge i chunk di codice effettivi dai file locali (in privacy mode il codice non esce mai dalla macchina, solo gli embedding sono server-side)
- Reranking: un cross-encoder riordina i risultati per rilevanza
- Assemblaggio contesto: i chunk migliori vengono inseriti nel prompt
Performance: un progetto da ~15.000 file si indicizza in ~6.5 minuti. Monorepo da ~80.000 file in ~38 minuti. Oltre 50.000 file l'auto-indicizzazione non parte.
Il trade-off: l'infrastruttura è opaca (embedding proprietario, server-side) e non hai modo di verificare o correggere cosa viene indicizzato e come. Più avanti vedremo perché questo è un problema più serio di quanto sembri.
Gemini CLI: La Finestra Gigante
Gemini CLI è l'approccio più radicale: niente indice, niente embedding, niente RAG. Scommette tutto sulla finestra da 1 milione di token.
La filosofia è: se hai abbastanza RAM, non ti serve un indice.
Come funziona:
- All'avvio genera un albero di file e cartelle del progetto (solo la struttura, non i contenuti) e lo inserisce come primo messaggio nascosto
- Legge i file on demand con tool:
ReadFile,ReadManyFiles,SearchText,Shell - Carica i GEMINI.md dal progetto (gerarchici: globale, progetto, sotto-cartelle)
- Non ha un meccanismo di compattazione documentato pubblicamente — è probabile che Google faccia trimming o summary silenzioso, ma non è trasparente. La scommessa dichiarata è che 1M token siano "abbastanza"
Il vantaggio: semplicità e trasparenza. Con 1M token puoi caricare circa 30.000 righe di codice in un singolo passaggio. E Google non sta ferma: usa tecniche di Attention Spacing e Caching lato server che rendono quei token più "freschi" di quanto suggeriscano i benchmark generici. La finestra da 1M non è un semplice buffer — è ottimizzata, anche se i dettagli non sono pubblici.
Il trade-off: nessun meccanismo per gestire il riempimento della finestra. Se la conversazione diventa lunga, non c'è compattazione. E come vedremo nella sezione successiva, una finestra più grande non significa automaticamente risposte migliori.
GitHub Copilot: L'Ibrido
Copilot (su VS Code) usa un approccio ibrido che combina elementi di tutti gli altri:
- Indice del workspace con embedding per ricerca semantica (come Cursor)
- Agent mode con ciclo agentico autonomo: scopre file, propone modifiche, esegue comandi (come Claude Code)
- Compattazione asincrona al 95% con sistema di checkpoint/rollback — se la compattazione fallisce, ripristina l'ultimo stato stabile
- Sub-agent specializzati nella CLI: Explore, Task, Plan, Code-review, che possono girare in parallelo
Tool output su disco: se l'output di un tool supera ~10KB, viene scritto su disco e al modello viene passato solo il path — una strategia intelligente per non riempire la finestra con output enormi.
Tabella Comparativa
| Caratteristica | Claude Code | Codex CLI | Cursor | Gemini CLI |
|---|---|---|---|---|
| Open source | No | Sì (MIT, Rust) | No | Sì (Apache 2.0, TS) |
| Indicizzazione codebase | No | No | Sì (embedding + Turbopuffer) | No |
| Come trova i file | Tool call on-demand | Tool call on-demand | RAG vettoriale + reranking | Tool call on-demand |
| Context window | 200K | 180-244K (model-dependent) | ~200K (Max Mode estende) | 1M |
| Compattazione | Auto al 95%, riassunto LLM | Auto al 95%, addestrata nel modello | Auto ~70-80%, riassunto LLM + /summarize manuale | Non documentata pubblicamente |
| Sub-agent | Sì (Explore, Plan) | No (singolo mega-agente) | Background agent per CI/test | No |
| Sandbox | Sì | Sì (OS-level) | IDE sandbox | Conferma utente |
| File istruzioni | CLAUDE.md | AGENTS.md / config.toml | .cursorrules | GEMINI.md |
Quindi Chi Funziona Meglio?
La risposta onesta è: dipende da cosa stai facendo. Ma avendo usato questi tool quotidianamente, un'opinione me la sono fatta.
Dove brilla ciascuno
Claude Code e Codex CLI — i tool "esploratori" senza indice — funzionano sorprendentemente bene su task mirati: fix un bug, implementa una feature specifica, refactora un componente. Il modello decide cosa leggere, legge solo quello che serve, e il contesto resta pulito. Quando il task è chiaro e lo scope è contenuto, l'assenza di indicizzazione non è un problema — è un vantaggio, perché non c'è rumore da retrieval impreciso.
Cursor brilla quando lavori su progetti che non conosci bene o quando il task tocca molti file correlati. Il @codebase ti salva quando non sai nemmeno dove cercare. Per refactoring che toccano 20 file, avere un indice semantico fa la differenza. Ma il vantaggio si riduce man mano che conosci meglio il progetto — a quel punto sai già dove guardare, e l'indicizzazione è overhead.
Gemini CLI con la finestra da 1M è comodo per progetti piccoli dove puoi caricare quasi tutto. Niente da configurare, niente da aspettare. Ma su progetti grandi la scommessa "butto tutto dentro" si rivela fragile — i dati sulla context pollution che vedremo tra poco spiegano perché.
Includere file o dare specifiche? Il dilemma vero
C'è una questione di fondo che va oltre il singolo tool e che riguarda come usiamo tutti questi strumenti.
Quando includiamo un file nel contesto — con @file in Cursor, facendolo leggere all'agente, o trascinandolo in una chat — spesso è un atto di pigrizia. Invece di scrivere "implementa un'API REST con endpoint GET /users, POST /users, DELETE /users/:id, schema Zod per validazione, pattern repository", buttiamo dentro 500 righe di un file simile e diciamo "fai come questo".
Cinquecento righe di contesto per comunicare qualcosa che si poteva dire in tre. Ogni token di quel file è un token in meno per la risposta e per il resto del contesto. Moltiplicalo per tutte le volte che lo fai in una sessione e capisci dove va a finire la finestra.
Detto questo: l'esempio concreto guida il modello meglio delle istruzioni astratte. È un fatto. Il modello che vede un componente Vue reale del tuo progetto replicherà quello stile con più precisione di quanto farebbe leggendo "usa TypeScript strict con composable per la logica". La similitudine funziona.
Il punto è trovare il bilanciamento. Un esempio mirato di 30 righe vale più di un file intero da 500. E tre righe di specifiche tecniche precise valgono più di un esempio generico buttato dentro "così capisce".
Il trade-off architetturale di Cursor
C'è un aspetto tecnico dell'approccio di Cursor che vale la pena considerare: il modello che indicizza non è lo stesso che ragiona. È una normale architettura RAG — succede in tutti i sistemi di retrieval — ma ha implicazioni pratiche.
Il modello di embedding proprietario di Cursor decide quali chunk di codice sono "rilevanti" per la tua domanda. Il modello che poi ragiona su quei chunk — Claude, GPT o chi scegli tu — ha una sua rappresentazione semantica diversa. Questo può introdurre mismatch semantici in alcuni casi: il retrieval porta contesto che l'embedding considera simile ma che il modello di reasoning non avrebbe cercato.
Non è un bug, è un trade-off ingegneristico. L'alternativa — Claude Code e Codex CLI dove lo stesso modello decide cosa cercare e ci ragiona sopra — ha il vantaggio della coerenza ma lo svantaggio di dipendere interamente dalla capacità del modello di navigare il codebase con tool call sequenziali.
La mia opinione, ad oggi
- Per task di sviluppo focalizzati (il 70% del lavoro reale): Claude Code o Codex CLI. Contesto pulito, il modello naviga dove serve
- Per esplorare codebase sconosciuti: Cursor. L'indice semantico compensa la mancanza di conoscenza del progetto
- Per prototipi rapidi e progetti piccoli: Gemini CLI. Zero setup, finestra enorme, carica e via
- Per sessioni lunghe e complesse: Codex CLI (compattazione addestrata nel modello) o Claude Code (sub-agent che isolano il contesto)
Ma la verità è che il tool conta meno di come lo usi. Un CLAUDE.md ben scritto con sessioni corte e mirate in Claude Code batte una sessione infinita in Cursor con @codebase a ogni messaggio. Perché il vero nemico è la context pollution — e quella non dipende dal tool, dipende da te.
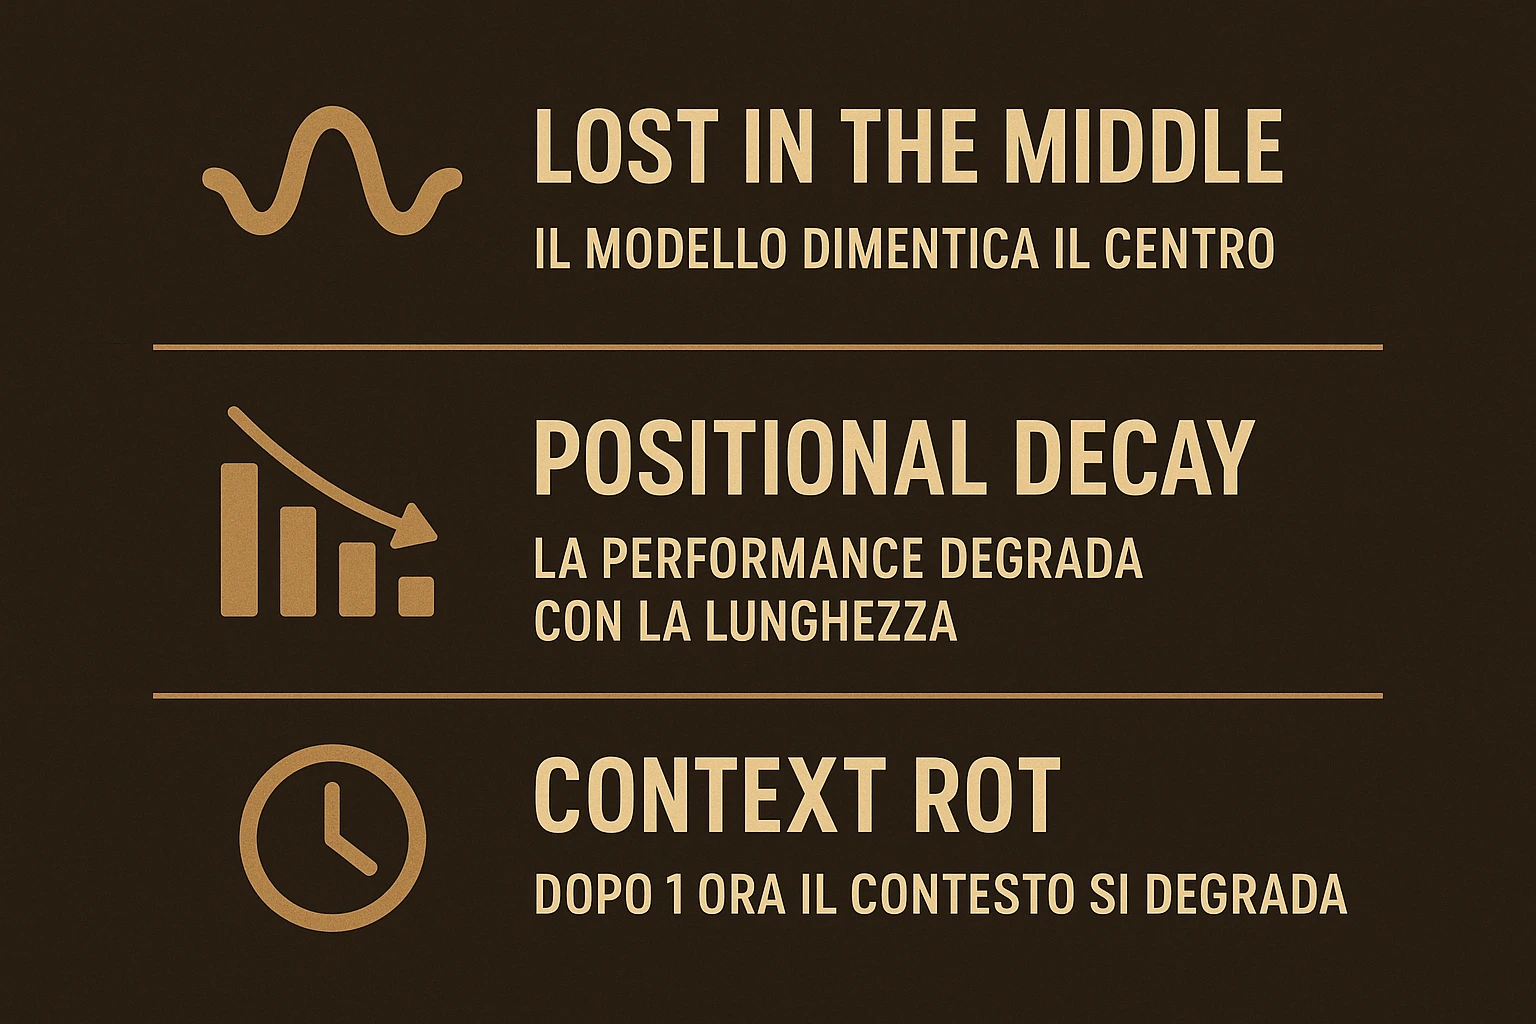
Context Pollution: I Tre Fenomeni Che Degradano Le Risposte
Fin qui abbiamo parlato di architetture e opinioni. Ora parliamo di cosa succede davvero alla qualità delle risposte quando la finestra si riempie. Esistono tre fenomeni distinti, documentati da paper peer-reviewed, e capirli cambia il modo in cui lavori.
1. Lost in the Middle (Positional Bias)
Il paper di Liu et al. (2024, pubblicato in Transactions of the ACL) ha documentato il primo fenomeno: le informazioni al centro di un contesto lungo vengono "dimenticate" rispetto a quelle all'inizio e alla fine.
L'esperimento: piazza un documento rilevante tra documenti distrattori in posizioni diverse (1°, 5°, 10°, 15°, 20°). Misura l'accuratezza del modello nel trovare l'informazione.
Risultato: la performance segue una curva a U. Alta all'inizio, alta alla fine, crolla nel mezzo. Con GPT-3.5 Turbo e 20 documenti, l'accuratezza con il documento rilevante al centro scendeva sotto la baseline senza documenti (56.1%). In altre parole: dare al modello informazione nel posto sbagliato era peggio che non dargliene affatto.
Questo è il Positional Bias: il modello non tratta tutte le posizioni nella finestra allo stesso modo. I token all'inizio (system prompt, CLAUDE.md) e quelli alla fine (il tuo ultimo messaggio) hanno un peso sproporzionato rispetto a tutto quello che sta in mezzo.
Cosa significa per te: quando il tuo agente legge 15 file per capire un problema, i file letti nelle posizioni centrali della cronologia sono nella zona di degradazione. Il modello "vede" bene i primi e gli ultimi, il mezzo è sfocato. Ed è un limite architetturale dei transformer, non un bug che verrà fixato.
2. Positional Encoding Decay (La Lunghezza Tende a Degradare)
Il secondo fenomeno è più sottile. Il paper "Context Length Alone Hurts LLM Performance Despite Perfect Retrieval" (ottobre 2025) mostra che anche con zero distrazione e retrieval perfetto, la performance tende a degradare progressivamente per il solo fatto che l'input è lungo.
Non è il rumore a fare danni. Non è l'informazione irrilevante. È la lunghezza in sé. I positional encoding — il meccanismo che dice al modello "questo token è in posizione X" — tendono a degradare con la distanza. Più token ci sono, più il modello fatica a mantenere relazioni tra parti distanti del contesto.
Un caveat importante: il decadimento non è lineare né identico per tutti i modelli. Le architetture moderne usano tecniche come RoPE scaling, sliding window attention e attention sparsity che mitigano il problema. Ma non lo eliminano — lo spostano più in là.
Con Llama-3.1-8B a 30K token:
- HumanEval (codice): -47.6%
- MMLU (conoscenza generale): -24.2%
- Variable Summation: -85%
Anche inserendo solo spazi bianchi come padding — letteralmente nessuna informazione distrattore — il calo era del 7-48%.
Questo spiega perché la finestra "effettiva" è sempre più piccola di quella pubblicizzata. Il benchmark NoLiMa (Adobe Research, 2025) lo ha misurato togliendo le scorciatoie lessicali dai test standard:
| Modello | Baseline (corto) | A 8K token | A 32K token | Calo |
|---|---|---|---|---|
| GPT-4o | 99.3% | 89.2% | 69.7% | -30% |
| Claude 3.5 Sonnet | 87.6% | 61.7% | 29.8% | -66% |
| Llama 3.3 70B | 97.3% | 72.1% | 42.7% | -56% |
| Command R+ | 90.9% | 39.5% | 7.4% | -92% |
A 32K token — il 25% di una finestra da 128K — 11 modelli su 12 erano già sotto il 50% della loro baseline. E questi sono i migliori modelli disponibili.
3. Context Rot (Il Degrado Cumulativo)
Il terzo fenomeno è il più rilevante per chi usa AI coding tutti i giorni: il Context Rot, documentato dallo studio Chroma (2025) su 18 modelli.
A differenza dei primi due fenomeni (che riguardano una singola chiamata con un contesto lungo), il Context Rot descrive il degrado progressivo nelle conversazioni multi-turn — esattamente lo scenario di una sessione di lavoro con un agente.
L'accuratezza è scesa dal 90% al 51% man mano che il contesto accumulava turni di conversazione. Un singolo elemento distrattore già riduce la performance. Quattro distrattori la peggiorano ulteriormente.
Il Context Rot è insidioso perché non te ne accorgi. Le prime risposte della sessione sono ottime. Man mano che lavori, l'agente legge file, esegue comandi, tu dai feedback, il contesto cresce — e la qualità scende gradualmente. Non c'è un momento in cui "si rompe". Semplicemente le risposte diventano meno precise, le decisioni meno azzeccate, le allucinazioni più frequenti. E tu pensi che il modello "è stupido" quando in realtà è il contesto che si è degradato.
Un dato che dovrebbe far riflettere i fan delle finestre giganti: GPT-4.1 (1M token), testato da Zep con conversazioni che usavano solo il 10% della finestra (~115K token), ha ottenuto un'accuratezza complessiva del 56.72% — inferiore a GPT-4o-mini, un modello più piccolo e più economico.
Finestra più grande ≠ risultati migliori. A volte è esattamente il contrario.
Come si sommano
Questi tre fenomeni non si escludono — si sommano:
- Mandi un messaggio lungo (Positional Encoding Decay: la lunghezza da sola degrada)
- Le informazioni utili finiscono nel mezzo (Lost in the Middle: il modello le ignora)
- Continui a lavorare per un'ora (Context Rot: ogni turno aggiunge rumore cumulativo)
Il risultato è che dopo una sessione intensa, il tuo agente sta operando con una frazione della sua capacità reale. Non perché il modello sia peggiorato — perché il contesto l'ha affogato.
La Compattazione: Cosa Si Perde Davvero
Quando la finestra si riempie, i tool compattano. Ma la compattazione non è magia — è un riassunto, e ogni riassunto perde informazioni.
Factory.ai ha valutato 36.611 messaggi di sessioni di coding reali, confrontando la qualità della compattazione di diversi provider. Le compressioni rimuovono il 98-99% dei token (impressionante). Ma la qualità?
| Dimensione | Punteggio (su 5) |
|---|---|
| Completezza | 4.37-4.44 |
| Accuratezza | 3.43-4.04 |
| Continuità | 3.67-3.80 |
| Artifact Trail (path file, nomi variabili) | 2.19-2.45 |
Il dato killer: l'artifact trail — i percorsi dei file, i nomi delle variabili, i messaggi di errore esatti — è la dimensione con il punteggio più basso. Sono esattamente i dettagli tecnici di cui hai bisogno per scrivere codice.
In pratica:
- Dopo una compattazione, l'agente potrebbe ricordare che "c'era un bug nell'autenticazione" ma non il file esatto o il nome della funzione
- Le istruzioni del CLAUDE.md possono essere ignorate o attenuate dopo compattazione
- Compattazioni multiple creano degrado cumulativo: riassunti di riassunti, dove ogni passaggio perde dettagli
Codex CLI ha dovuto riscrivere il proprio sistema di compattazione proprio per questo motivo — il vecchio approccio creava "riassunti di riassunti" che degradavano rapidamente.
Masking vs Summarization: La Sorpresa
La ricerca di JetBrains (NeurIPS 2025) ha confrontato due strategie:
- Observation masking: semplicemente nascondere i risultati dei tool più vecchi di 10 turni
- LLM summarization: usare un LLM per riassumere la cronologia
Il risultato: nei benchmark testati (SWE-bench Verified), il masking semplice ha ottenuto risultati alla pari o meglio del riassunto LLM, costando il 50% in meno.
Un effetto collaterale interessante: gli agenti con summarization giravano il 15% più a lungo (più turni) rispetto a quelli con masking. La spiegazione? I riassunti "lisciavano" i segnali di stop — l'agente non capiva più quando aveva finito.
La soluzione migliore nei loro test: un approccio ibrido (masking + riassunto selettivo) che ha ottenuto +2.6% sul tasso di risoluzione risparmiando il 7% rispetto al solo masking.
La lezione: in molti casi pratici, la soluzione semplice (nascondere il vecchio) compete con quella sofisticata (riassumere con un LLM). Non è una regola universale — dipende dal task, dal tipo di memoria necessaria e dalla compressione semantica richiesta — ma suggerisce che la complessità aggiuntiva non sempre ripaga.
Il limite del masking però è reale: se il bug che stai risolvendo ora è causato da una modifica fatta 20 messaggi fa — e quel contesto è stato mascherato — l'AI non potrà mai arrivarci per deduzione. Il contesto è sparito. È il prezzo della semplicità: guadagni pulizia, perdi tracciabilità. Per questo i checkpoint espliciti (di cui parliamo tra poco) diventano fondamentali.
La Memoria: Cosa Persiste e Cosa No
"Ma si ricorda quello che gli ho detto ieri?"
Risposta breve: no, a meno che non ci sia un meccanismo esplicito.
Sessione = Contesto Nuovo
Ogni nuova sessione parte da zero. La context window viene ricostruita da capo: system prompt, istruzioni progetto, basta. Niente di quello che hai detto nella sessione precedente.
I Meccanismi di Persistenza
- Claude Code: salva riassunti di sessione in file locali. In più, tutto quello che scrivi nel CLAUDE.md è persistente per definizione
- Codex CLI: cronologia in file JSONL + metadata in SQLite. Supporta
codex resumeper riprendere sessioni - Cursor: indice codebase persistente +
.cursorrules+ "notepads" per contesto manuale - Gemini CLI: file
GEMINI.mdgerarchici (globale, progetto, sotto-cartelle). L'estensione Conductor aggiunge file Markdown versionati per decisioni architetturali e piani di lavoro
Il Filesystem Come Memoria
Una delle strategie più efficaci viene dal team di Manus: usare il filesystem come memoria esterna illimitata. L'agente scrive continuamente un file todo.md che riscrive e aggiorna durante il lavoro. Ogni volta che il contesto viene compattato o si apre una nuova sessione, quel file è lì, pronto per essere riletto.
Anthropic stessa usa una strategia simile per agenti di lunga durata: un file progress.txt che l'agente aggiorna, combinato con la storia git.
Non è elegante. Ma funziona. E funziona meglio dei vector database sofisticati per molti use case, perché il file è ispezionabile, editabile e deterministico.
Il Problema delle Istruzioni: Chi Vince?
C'è una gerarchia in quello che l'AI "ascolta":
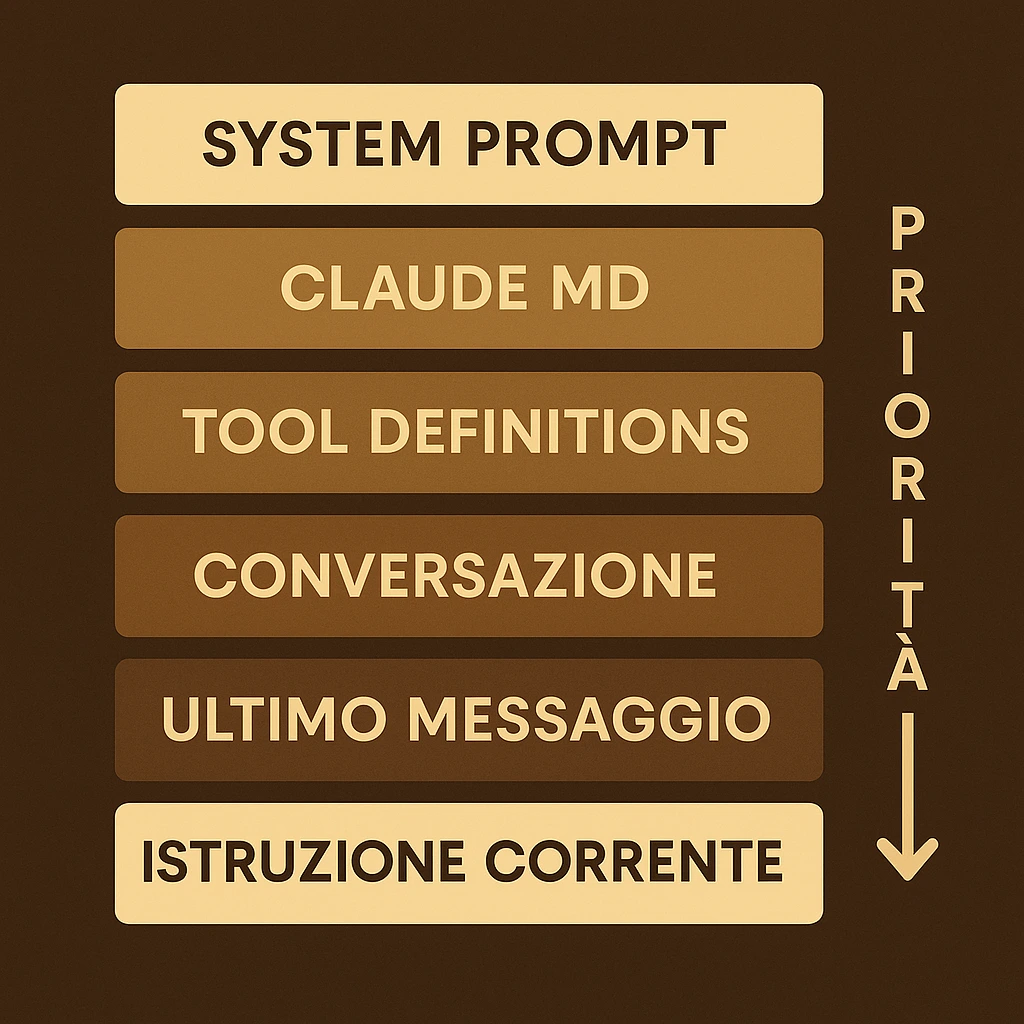
Il paradosso: il tuo messaggio ha la priorità più bassa in teoria, ma l'AI tende a dare peso al messaggio più recente. Se l'AI sembra "non ascoltarti", potrebbe essere perché le tue istruzioni confliggono con istruzioni di livello superiore. Non è un bug, è una feature di sicurezza.
Il team di Manus ha scoperto una cosa correlata: l'agente tende a imitare i pattern della conversazione recente. Se gli ultimi 10 turni contengono output serializzati allo stesso modo, l'agente "si fissa" su quel formato. La soluzione: introdurre variazione strutturata nella serializzazione per evitare l'overfitting.
Sub-Agent: Dividere Per Non Inquinare
Quando un task è troppo grande per una singola finestra, alcuni tool usano sub-agent: agenti specializzati con contesti separati.
- L'agente principale riceve la tua richiesta
- Crea un sub-agent con un compito specifico ("analizza la struttura del database")
- Il sub-agent ha la sua context window separata, lavora, e restituisce solo il risultato
- L'agente principale riceve un riassunto compatto, non l'intera cronologia del sub-agent
Anthropic raccomanda esplicitamente questa strategia: i sub-agent consumano decine di migliaia di token ma restituiscono 1.000-2.000 token di risultato. È un'ammissione implicita che riempire una singola finestra è peggio che distribuire il lavoro.
Chi usa sub-agent:
- Claude Code: sì (Explore, Plan, agenti specializzati)
- GitHub Copilot CLI: sì (4 agenti paralleli: Explore, Task, Plan, Code-review)
- Codex CLI: no (singolo mega-agente)
- Gemini CLI: no (singolo agente)
Il trade-off: contesto isolato = meno rumore ma meno comprensione globale. Il sub-agent non sa cosa ti sei detto prima. Se il contesto della conversazione è importante per il sotto-task, va passato esplicitamente.
Implicazioni Pratiche: Cosa Cambia Per Te
Tutto questo si traduce in regole operative:
1. Sessioni Corte, Task Specifici
Non lavorare per ore sulla stessa sessione sperando che l'AI "ricordi tutto". I dati sono chiari: la qualità degrada con la lunghezza. Meglio sessioni focalizzate: un task, una sessione.
2. Il File di Istruzioni È il Tuo Investimento Migliore
Ogni token speso nel CLAUDE.md (o equivalente) viene riletto a ogni sessione. Metti lì le convenzioni importanti, gli esempi, i pattern. È la memoria più affidabile che hai — sopravvive a compattazioni, nuove sessioni, tutto.
3. Non Caricare Tutto, Carica il Giusto
"Leggi tutti i file nella cartella src" è quasi sempre sbagliato. "Leggi il file che gestisce l'autenticazione" è quasi sempre giusto. I dati NoLiMa sono chiari: a 32K token la maggior parte dei modelli è già sotto il 50%. Meno contesto irrilevante = meno rumore = risposte migliori.
4. Quando Cambi Argomento, Cambia Sessione
Se stai lavorando sul frontend e poi passi al backend, la cronologia del frontend è solo rumore che contribuisce alla context pollution. Nuova sessione, contesto pulito.
5. Se l'AI "Dimentica", Non È Stupida
Probabilmente il contesto rilevante è stato compattato (e ha perso i dettagli tecnici — ricordi il punteggio 2.19/5 sull'artifact trail?) o è finito nella zona "lost in the middle". Ripeti l'informazione importante nel messaggio corrente. Ridondanza mirata > assumere che ricordi.
6. Usa il .gitignore Anche Per l'AI
Se usi Cursor o qualsiasi tool con indicizzazione, ricordati che indicizza tutto quello che non è escluso. Se le tue cartelle dist/, build/, node_modules/ o i file generati finiscono nell'indice, stai inquinando il contesto con spazzatura. Verifica che il tuo .gitignore (o l'equivalente del tool) escluda tutto ciò che non è codice sorgente rilevante.
7. Checkpoint Espliciti: L'Antidoto al Context Rot
Quando l'AI arriva a una soluzione parziale corretta — un'architettura definita, una decisione presa, un componente che funziona — falla scrivere su un file. architecture_decisions.md, progress.md, un commento nel codice. Poi chiudi la sessione e riparti.
È l'unico modo concreto per battere il Context Rot: cristallizzare le decisioni fuori dalla finestra prima che il degrado le corrompa. La sessione successiva rilegge il file e riparte con contesto pulito e decisioni preservate.
8. Dai Tipi, Non Implementazioni
In linguaggi tipizzati come TypeScript o Rust, fornire all'AI le definizioni dei tipi (.d.ts, interface, struct) è enormemente più efficace che fornirle l'implementazione di 5 file. Un'interfaccia TypeScript di 20 righe comunica la stessa informazione strutturale di 300 righe di implementazione — usando un quindicesimo dei token.
Quando devi dare contesto all'agente su una parte del codebase che non sta leggendo direttamente, passa i tipi e le interfacce. Non le implementazioni.
9. Scegli il Tool Giusto Per il Task Giusto
- Progetto piccolo, task rapidi: Gemini CLI con la sua finestra da 1M è comodo — carica molto, non devi pensare alla gestione
- Progetto grande, refactoring complessi: Cursor con il suo indice vettoriale trova codice rilevante che gli altri non vedrebbero
- Sessioni lunghe e multi-step: Codex CLI con compattazione addestrata nel modello o Claude Code con sub-agent
- Automazione headless: Codex CLI (ha
codex-execper output JSON) o Claude Code (mode non interattivo)
Il Quadro Generale
Il context engineering non è un concetto astratto. È il meccanismo che determina se l'AI coding funziona o no.
Quando un agente produce codice sbagliato, nella maggior parte dei casi il problema non è il modello — è il contesto. Informazione mancante, contesto degradato, istruzioni conflittuali, troppo rumore nella finestra.
Come ha scritto Philipp Schmid: "I fallimenti degli agenti sono tipicamente fallimenti di contesto, non fallimenti di modello."
I dati sono impietosi: a 32K token la maggior parte dei modelli perde metà della propria capacità. La compattazione salva il 98% dei token ma perde i dettagli tecnici che servono di più. E una finestra da 1M token non batte automaticamente una da 200K ben gestita.
La buona notizia: a differenza del modello (che non puoi migliorare), il contesto lo controlli tu. Ogni CLAUDE.md ben scritto, ogni richiesta precisa, ogni sessione pulita è context engineering.
Non serve una laurea in deep learning per usare bene l'AI coding. Ma serve capire cosa c'è nella finestra — e ora lo sai.
Fonti:
- Liu et al. — Lost in the Middle (ACL 2024)
- NoLiMa — Adobe Research (2025)
- Context Length Alone Hurts LLM Performance (arXiv 2025)
- Chroma — Context Rot Study (2025)
- Factory.ai — Evaluating Compression (2025)
- JetBrains Research — The Complexity Trap (NeurIPS 2025)
- Zep — GPT-4.1 Long Context Analysis
- Anthropic — Context Engineering for AI Agents
- Manus — Context Engineering Lessons
- Martin Fowler — Context Engineering for Coding Agents
- Wietse Venema — How Gemini CLI Builds Context
- DeepWiki — openai/codex Architecture