Attention Is All You Need: La Rivoluzione in 11 Pagine
Il paper del 2017 che ha creato ChatGPT, Copilot e Claude. L'architettura Transformer spiegata pezzo per pezzo, senza formule, con analogie da dev.
Alessandro Saiani
Human in the Loop
Nel giugno 2017, otto ricercatori di Google pubblicano un paper di 11 pagine con un titolo ambizioso: "Attention Is All You Need". Nessuno di loro sa che quel paper diventerà il più citato nella storia del machine learning moderno — e il fondamento di tutto: GPT, Claude, Gemini, Copilot, Cursor, ogni tool AI che usi oggi.
Il paper ha oltre 150.000 citazioni. Ha generato un'industria da centinaia di miliardi di dollari. E la cosa assurda è che l'idea centrale è elegantemente semplice.
Vediamo cosa dice, come funziona, e perché ha cambiato tutto.
Il problema che volevano risolvere
Nel 2017, il modo standard di processare sequenze (testo, audio, codice) era con le RNN (Recurrent Neural Networks) e le loro varianti LSTM e GRU.
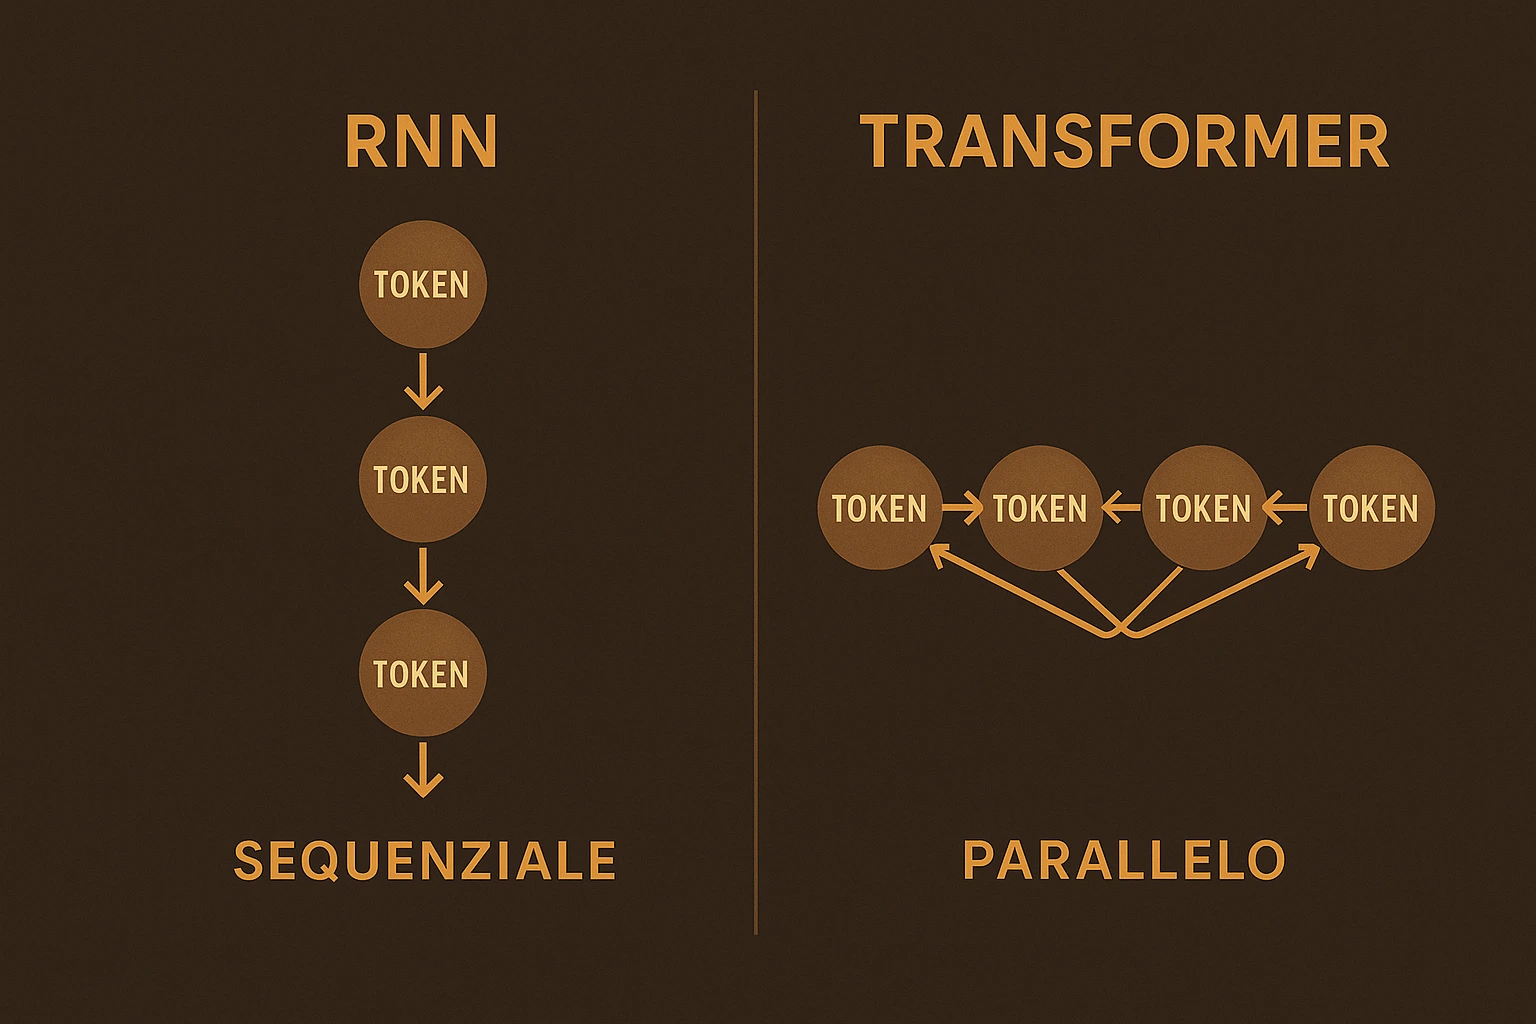
Il problema delle RNN in una frase: processano un token alla volta, in ordine.
Input: "Il gatto si siede sul tappeto"

RNN: Il → gatto → si → siede → sul → tappeto
     ↓      ↓       ↓      ↓       ↓      ↓
    h1  →  h2  →  h3  →  h4  →  h5  →  h6
Ogni token deve aspettare che il precedente sia stato processato. Questo crea due problemi enormi:
1. Non puoi parallelizzare. Se hai 1000 token, devi fare 1000 step sequenziali. Con le GPU moderne che hanno migliaia di core paralleli, è come avere un'autostrada a 16 corsie e poter usare solo la prima.
2. Le dipendenze a lunga distanza si perdono. In una frase come "Il programmatore che aveva iniziato il progetto tre mesi fa ha finalmente deployato", la RNN deve passare l'informazione "programmatore" attraverso tutti i token intermedi. Ad ogni passaggio, un po' di segnale si perde — come un telefono senza fili.
I ricercatori di Google si chiedono: e se eliminassimo del tutto la ricorrenza?
L'intuizione: l'Attention è tutto ciò che serve
L'attention mechanism esisteva già prima del 2017. Bahdanau lo aveva proposto nel 2014 come aggiunta alle RNN per la traduzione automatica. Ma era un complemento — le RNN facevano ancora il lavoro pesante.
La svolta del paper è radicale: togliere le RNN completamente e costruire un modello basato solo sull'attention.
L'intuizione è questa: quando leggi una frase, non la processi un token alla volta. Il tuo cervello guarda tutta la frase insieme e decide quali parole sono rilevanti per capire ogni altra parola.
"Il server che gestisce le API REST ha crashato alle 3 di notte"

Per capire "ha crashato", il modello deve guardare:
  - "server" → chi ha crashato?
  - "API REST" → che tipo di server?
  - "3 di notte" → quando?
L'attention permette a ogni token di "guardare" tutti gli altri token nella sequenza, contemporaneamente, e decidere a quali prestare attenzione. Nessun passaggio sequenziale. Tutto in parallelo.
L'architettura Transformer
Il Transformer ha una struttura encoder-decoder, progettata originariamente per la traduzione:
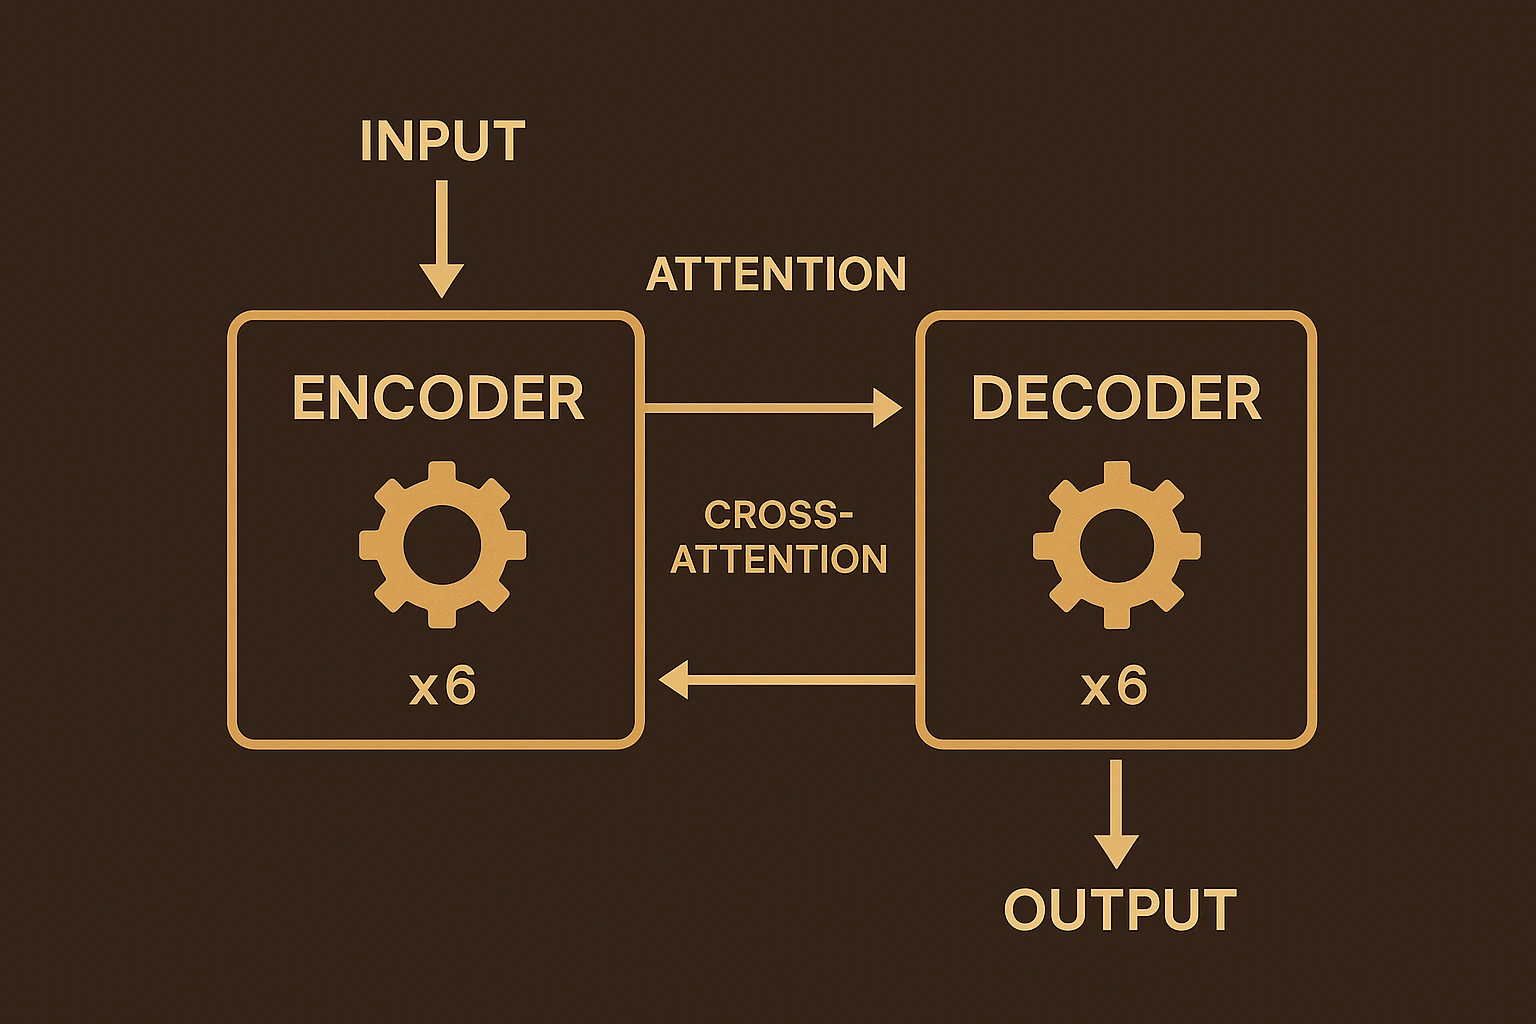
L'encoder prende l'input e crea una rappresentazione ricca del significato. Il decoder usa quella rappresentazione per generare l'output, un token alla volta.
Ma il cuore di tutto è dentro quei blocchi. Ogni blocco encoder e decoder contiene lo stesso ingrediente magico: il self-attention.
Query, Key, Value: l'analogia del database
Il meccanismo di self-attention usa tre concetti presi in prestito dai database: Query, Key e Value.
L'analogia più utile per uno sviluppatore:
Immagina un database NoSQL dove ogni documento ha una chiave (Key) e un contenuto (Value). Tu fai una ricerca (Query) e il sistema ti restituisce i documenti più rilevanti, pesati per quanto matchano la tua query.
// Pseudocodice concettuale
function selfAttention(tokens) {
  for (let i = 0; i < tokens.length; i++) {
    const query = tokens[i].asQuery()    // "Cosa sto cercando?"

    const scores = tokens.map(t => {
      const key = t.asKey()              // "Cosa ho da offrire?"
      return dotProduct(query, key)      // Quanto matcha?
    })

    const weights = softmax(scores)      // Normalizza in probabilità

    const output = weightedSum(
      tokens.map(t => t.asValue()),      // "Il mio contenuto"
      weights
    )

    results[i] = output
  }
  return results
}
In pratica, per ogni token nella sequenza:
- Query: "Di cosa ho bisogno per capire il mio significato?"
- Key: Ogni altro token dice "Ecco cosa posso offrirti"
- Score: Il dot product tra Query e Key misura la compatibilità
- Softmax: Trasforma gli score in pesi che sommano a 1
- Value: Il contenuto effettivo di ogni token, pesato per rilevanza
Il risultato è che ogni token ottiene una nuova rappresentazione che incorpora informazioni da tutta la sequenza, pesate per rilevanza.
Perché "Multi-Head"?
Il paper non usa un solo meccanismo di attention. Ne usa 8 in parallelo — le famose "multi-head attention".
Perché? Perché una parola può essere rilevante per motivi diversi.
Prendiamo la frase:
"La funzione parseJSON che Marco ha scritto ieri gestisce male i null"
Per capire "gestisce", serve guardare:
- Head 1 (sintattica): "funzione" → chi gestisce? Il soggetto
- Head 2 (semantica): "parseJSON" → cosa gestisce? JSON parsing
- Head 3 (qualità): "male" → come gestisce? Male
- Head 4 (contesto): "null" → cosa gestisce male? I valori null
Ogni head impara a catturare un tipo diverso di relazione. È come avere 8 analisti che leggono lo stesso codice ma ognuno cerca qualcosa di diverso — uno guarda la struttura, uno i tipi, uno le dipendenze, uno i pattern.
In formula semplificata:
MultiHead = Concat(head_1, head_2, ..., head_8) × W_output

dove head_i = Attention(Q × W_Q_i, K × W_K_i, V × W_V_i)
Le matrici W_Q, W_K, W_V sono parametri appresi durante il training. Il modello impara da solo quali tipi di relazioni catturare in ogni head.
Il trucco della scala: √d_k
C'è un dettaglio che sembra insignificante ma è cruciale. Prima di applicare softmax, gli score vengono divisi per √d_k (la radice quadrata della dimensione delle key):
Attention(Q, K, V) = softmax(Q × K^T / √d_k) × V
Perché? Senza questa divisione, quando le dimensioni sono grandi (tipo 512), i dot product diventano numeri enormi. La softmax su numeri enormi produce distribuzioni quasi one-hot — un token prende peso ~1.0 e tutti gli altri ~0.0. L'attention smette di funzionare perché non riesce a catturare relazioni sfumate.
La divisione per √d_k riporta gli score in un range dove la softmax produce distribuzioni morbide e utili. È un dettaglio implementativo, ma senza di esso il Transformer non convergerebbe.
Positional Encoding: il problema dell'ordine
C'è un problema fondamentale nell'attention: è simmetrica. Se permuti l'ordine dei token, l'output non cambia. Per l'attention, "il gatto mangia il pesce" e "il pesce mangia il gatto" sono la stessa cosa.
Ma l'ordine conta, ovviamente. La soluzione del paper è elegante: aggiungere informazioni sulla posizione direttamente agli embedding.
input_finale = token_embedding + positional_encoding
Il paper usa funzioni sinusoidali con frequenze diverse per ogni dimensione:
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
L'intuizione: ogni posizione ha una "firma" unica fatta di seni e coseni a frequenze diverse. È come un codice a barre per la posizione. Le frequenze basse catturano la posizione assoluta ("sei all'inizio o alla fine?"), quelle alte catturano le distanze relative ("sei vicino o lontano dal token X?").
I modelli moderni (GPT, Claude, Llama) usano varianti più sofisticate come RoPE (Rotary Positional Embedding), ma l'idea di base è la stessa: iniettare informazione posizionale negli embedding.
Feed-Forward Network: il "ragionamento" locale
Ogni blocco Transformer non ha solo attention. Dopo il self-attention, c'è una Feed-Forward Network (FFN) — due layer lineari con un'attivazione ReLU in mezzo:
FFN(x) = ReLU(x × W1 + b1) × W2 + b2
Se l'attention è "raccogliere informazioni da tutta la sequenza", la FFN è "ragionare su quelle informazioni localmente". Alcuni ricercatori la interpretano come una memoria associativa — una lookup table appresa che mappa pattern a conoscenza.
Curiosità: la FFN occupa circa 2/3 dei parametri del Transformer. In GPT-3 (175B parametri), circa 120 miliardi sono nelle FFN. È lì che viene "memorizzata" la maggior parte della conoscenza del mondo del modello.
Residual Connections e Layer Norm
Ogni sotto-componente (attention e FFN) è avvolto in due meccanismi cruciali:
output = LayerNorm(x + SubLayer(x))
Residual connection (x + SubLayer(x)): il segnale originale viene sommato all'output del sublayer. Questo risolve il problema del vanishing gradient — in reti profonde (6+ layer), i gradienti durante il training tendono a diventare microscopici e il modello smette di imparare. Le residual connections creano "scorciatoie" per il gradiente.
Layer Normalization: normalizza le attivazioni per avere media 0 e varianza 1. Stabilizza il training e lo rende più veloce. Senza di essa, il modello diverge facilmente.
Questi due meccanismi sono il motivo per cui puoi impilare 6, 12, 96, o anche 128 layer senza che il training collassi. Sono "noiosi" ma fondamentali.
I numeri del paper originale
Il Transformer originale del 2017 è microscopico per gli standard attuali:
| Parametro | Transformer 2017 | GPT-4 (stima) | Claude Opus 4 |
|---|---|---|---|
| Layer | 6 encoder + 6 decoder | ~120 | Non pubblico |
| d_model | 512 | ~12.288 | Non pubblico |
| Attention heads | 8 | ~96 | Non pubblico |
| Parametri totali | ~65 milioni | ~1.8 trilioni (MoE) | Non pubblico |
| Context window | ~512 token | 128K token | 200K token |
| Training | 8 GPU, 3.5 giorni | ~25.000 GPU, mesi | Non pubblico |
La cosa impressionante: l'architettura di base è sostanzialmente identica. GPT-4 e Claude non hanno inventato una nuova architettura — hanno preso il Transformer del 2017, lo hanno ingrandito enormemente, e hanno migliorato il training. L'architettura ha scalato come nessun'altra prima.
Da encoder-decoder a decoder-only
Il paper originale usa sia encoder che decoder. Ma i modelli che usi oggi (GPT, Claude, Llama) usano solo il decoder. Perché?
L'encoder-decoder ha senso per task sequence-to-sequence come la traduzione: prendi un input completo, codificalo, poi genera l'output.
Ma per la generazione di testo (e codice), il task è diverso: prevedi il prossimo token dato tutto ciò che viene prima. Non c'è un "input completo" separato dall'"output" — tutto è un'unica sequenza.
Encoder-Decoder (traduzione):
  Input:  "The cat sits on the mat"  →  Encoder  →  rappresentazione
  Output: "Le chat est assis sur le tapis"  ←  Decoder  ←  rappresentazione

Decoder-Only (generazione):
  "Il gatto si" → "siede"
  "Il gatto si siede" → "sul"
  "Il gatto si siede sul" → "tappeto"
Il decoder-only usa una masked self-attention: ogni token può guardare solo i token precedenti, non quelli futuri. Questo è necessario per la generazione autoregressiva — non puoi guardare la risposta prima di generarla.
Token:    Il    gatto    si    siede    sul
Il        ✓      ✗       ✗      ✗       ✗
gatto     ✓      ✓       ✗      ✗       ✗
si        ✓      ✓       ✓      ✗       ✗
siede     ✓      ✓       ✓      ✓       ✗
sul       ✓      ✓       ✓      ✓       ✓
La maschera triangolare impedisce al modello di "sbirciare" il futuro. GPT-1 (2018) è stato il primo a dimostrare che un decoder-only Transformer, pre-addestrato su abbastanza testo, impara rappresentazioni generali utili per molti task.
Perché il Transformer ha vinto
Tre motivi principali per cui il Transformer ha dominato tutto ciò che è venuto prima:
1. Parallelizzabilità totale
Le RNN processano sequenzialmente — token dopo token. Il Transformer processa tutti i token contemporaneamente. Con GPU moderne che hanno migliaia di core, il training è ordini di grandezza più veloce.
2. Dipendenze a lunga distanza
Nell'attention, la distanza tra due token qualsiasi è sempre 1 step. Il token alla posizione 1 può interagire direttamente con il token alla posizione 10.000 senza passare per tutti quelli in mezzo.
RNN:   Token 1 ──→ ... ──→ Token 10.000  (9.999 step, segnale degradato)
Attn:  Token 1 ←────────→ Token 10.000   (1 step, connessione diretta)
3. Scaling prevedibile
I Transformer seguono le scaling laws (Kaplan et al., 2020): raddoppia i parametri e i dati, e la performance migliora in modo prevedibile. Nessuna architettura precedente scalava così bene. Questo ha dato alle aziende la fiducia per investire miliardi in modelli sempre più grandi.
Il costo: attenzione quadratica
Il Transformer non è perfetto. Il suo tallone d'Achille è la complessità quadratica dell'attention:
Costo attention = O(N² × d)

dove N = lunghezza sequenza, d = dimensione del modello
Raddoppia la lunghezza della sequenza → il costo quadruplica.
| Sequenza | Operazioni attention |
|---|---|
| 1K token | 1M |
| 4K token | 16M |
| 32K token | 1B |
| 128K token | 16B |
| 1M token | 1T |
Questo è il motivo per cui le context window sono limitate, e perché modelli con context lunghi (200K+ token) costano molto di più.
Soluzioni moderne:
- Flash Attention (Dao, 2022): non riduce la complessità teorica, ma ottimizza gli accessi alla memoria GPU rendendo l'attention 2-4x più veloce
- Sparse Attention: ogni token guarda solo un sottoinsieme degli altri token
- Ring Attention: distribuisce l'attention su multiple GPU
- Mamba/SSM: architetture alternative con complessità lineare (ma non hanno ancora superato i Transformer sui task linguistici)
Cosa significa per te che sviluppi
Se usi Claude Code, Cursor, Copilot o qualsiasi tool AI per scrivere codice, stai usando un discendente diretto di quel paper del 2017. Ecco cosa ti serve sapere in pratica:
La context window è la tua risorsa più preziosa. Ogni token nel contesto interagisce con ogni altro token via attention. Più è pieno di informazioni rilevanti, meglio il modello "capisce" il tuo codebase. Più è pieno di rumore, peggio lavora.
L'ordine conta (ma meno di quanto pensi). Grazie al positional encoding, il modello sa dove è ogni token. Ma l'attention permette connessioni dirette ovunque — mettere il file più importante all'inizio o alla fine del prompt non cambia molto quanto con le RNN.
I modelli grandi non sono "più intelligenti" — vedono più pattern. Più parametri nelle FFN = più conoscenza memorizzata. Più attention heads = più tipi di relazioni catturate. La differenza tra un modello da 7B e uno da 400B non è "ragionamento migliore" — è una base di conoscenza più ampia e pattern matching più fine.
La generazione è sequenziale, anche se il training è parallelo. Quando il modello genera codice, produce un token alla volta. Ogni token richiede un forward pass attraverso tutti i layer. Questo è il motivo per cui la generazione è più lenta dell'analisi — e perché tecniche come la speculative decoding sono importanti.
L'eredità
Il paper "Attention Is All You Need" ha un record probabilmente irraggiungibile: praticamente ogni modello AI di frontiera nel 2026 è un Transformer o una sua variante diretta.
Gli 8 autori originali hanno poi fondato o co-fondato aziende che valgono decine di miliardi di dollari: Cohere, Adept, Character.AI, Inceptive, Essential AI, Sakana AI. Il paper non ha solo creato un'architettura — ha creato un'industria.
Ma la lezione più profonda è un'altra. Nel 2017, l'idea di togliere le RNN e usare solo attention sembrava folle. Le RNN funzionavano. Avevano decenni di ricerca dietro. L'attention da sola? Nessuno sapeva se avrebbe scalato.
Ha scalato. E il resto è storia.
Fonti:
- Attention Is All You Need — Vaswani et al., 2017 (paper originale)
- The Illustrated Transformer — Jay Alammar
- Scaling Laws for Neural Language Models — Kaplan et al., 2020
- FlashAttention: Fast and Memory-Efficient Exact Attention — Dao et al., 2022
- Language Models are Few-Shot Learners (GPT-3) — Brown et al., 2020
- Improving Language Understanding by Generative Pre-Training (GPT-1) — Radford et al., 2018
- Google AI Blog — Transformer: A Novel Neural Network Architecture for Language Understanding
- The Annotated Transformer — Harvard NLP