RAG: Cos'è e Come Funziona
RAG riduce le allucinazioni degli LLM del 67%. Pipeline, architettura e implementazione del pattern più usato in produzione per dare contesto ai modelli AI.
Alessandro Saiani
Human in the Loop
Jerry Liu, CEO di LlamaIndex, lo ha detto senza giri di parole: "RAG is basically just a hack". E poi ha aggiunto: "but it turns out it's a very good hack". Ha ragione su entrambi i punti. RAG non è un'architettura elegante, non è un breakthrough teorico, non ha vinto nessun Nobel. È un trucco. Un trucco che ha ridotto le allucinazioni degli LLM fino al 67%, che alimenta un mercato da 1.94 miliardi di dollari nel 2025 (in crescita verso i 9.86 miliardi entro il 2030), e che probabilmente stai già usando senza saperlo ogni volta che apri Cursor o Claude.
RAG prende i concetti di embedding e similitudine vettoriale e li mette al lavoro in produzione.
Il Problema che RAG Risolve
Gli LLM hanno una memoria fissa. Tutto ciò che "sanno" è stato compresso nei pesi del modello durante il training — miliardi di parametri che codificano pattern estratti da internet. Ma quei pesi hanno una data di scadenza. Chiedi a GPT-4 le performance dell'ultimo trimestre della tua azienda: non le sa. Chiedigli della policy interna sulla gestione dei ticket: non la conosce. Chiedigli del bug introdotto ieri nel branch feature/auth: neanche a parlarne.
E quando un LLM non sa qualcosa, non dice "non lo so". Inventa. Con sicurezza. Con dettagli plausibili. Con citazioni che non esistono. Questa è l'allucinazione — il problema numero uno degli LLM in produzione.
RAG risolve questo problema con un'idea banale: prima di rispondere, vai a cercare le informazioni rilevanti. Non affidarti solo alla memoria del modello. Recupera i documenti giusti, infilali nel prompt, e poi genera la risposta basandoti su quelli.
È la differenza tra rispondere a un esame a libro chiuso e a libro aperto.
Il Paper Originale: Lewis et al., 2020
Il termine RAG nasce in un paper di Facebook AI Research (ora Meta AI) presentato a NeurIPS 2020: "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks". Autori: Patrick Lewis, Ethan Perez, Aleksandra Piktus e altri nove ricercatori di FAIR, UCL e NYU.
L'architettura originale aveva due componenti:
- Retriever: Dense Passage Retrieval (DPR) — cercava i top-5 passaggi più rilevanti da un indice di Wikipedia usando rappresentazioni vettoriali dense
- Generator: BART (modello seq2seq) — riceveva la query originale + i passaggi recuperati e generava la risposta
I risultati sui benchmark dell'epoca erano notevoli:
| Task | Dataset | RAG | Miglior risultato precedente | Delta |
|---|---|---|---|---|
| Open-Domain QA | Natural Questions | 44.5% | 36.6% | +7.9% |
| Open-Domain QA | TriviaQA | 56.8% | 50.1% | +6.7% |
| Fact Verification | FEVER | 70.0% | 65.1% | +4.9% |
L'intuizione chiave del paper: combinare memoria parametrica (i pesi del modello) con memoria non-parametrica (un indice di documenti aggiornabile). Il modello non deve memorizzare tutto — deve sapere dove cercare.
La Pipeline Moderna: Come Funziona nel 2026
Il RAG del paper originale usava DPR e BART. Nel 2026 i componenti sono cambiati, ma la struttura è la stessa: recupera, poi genera.
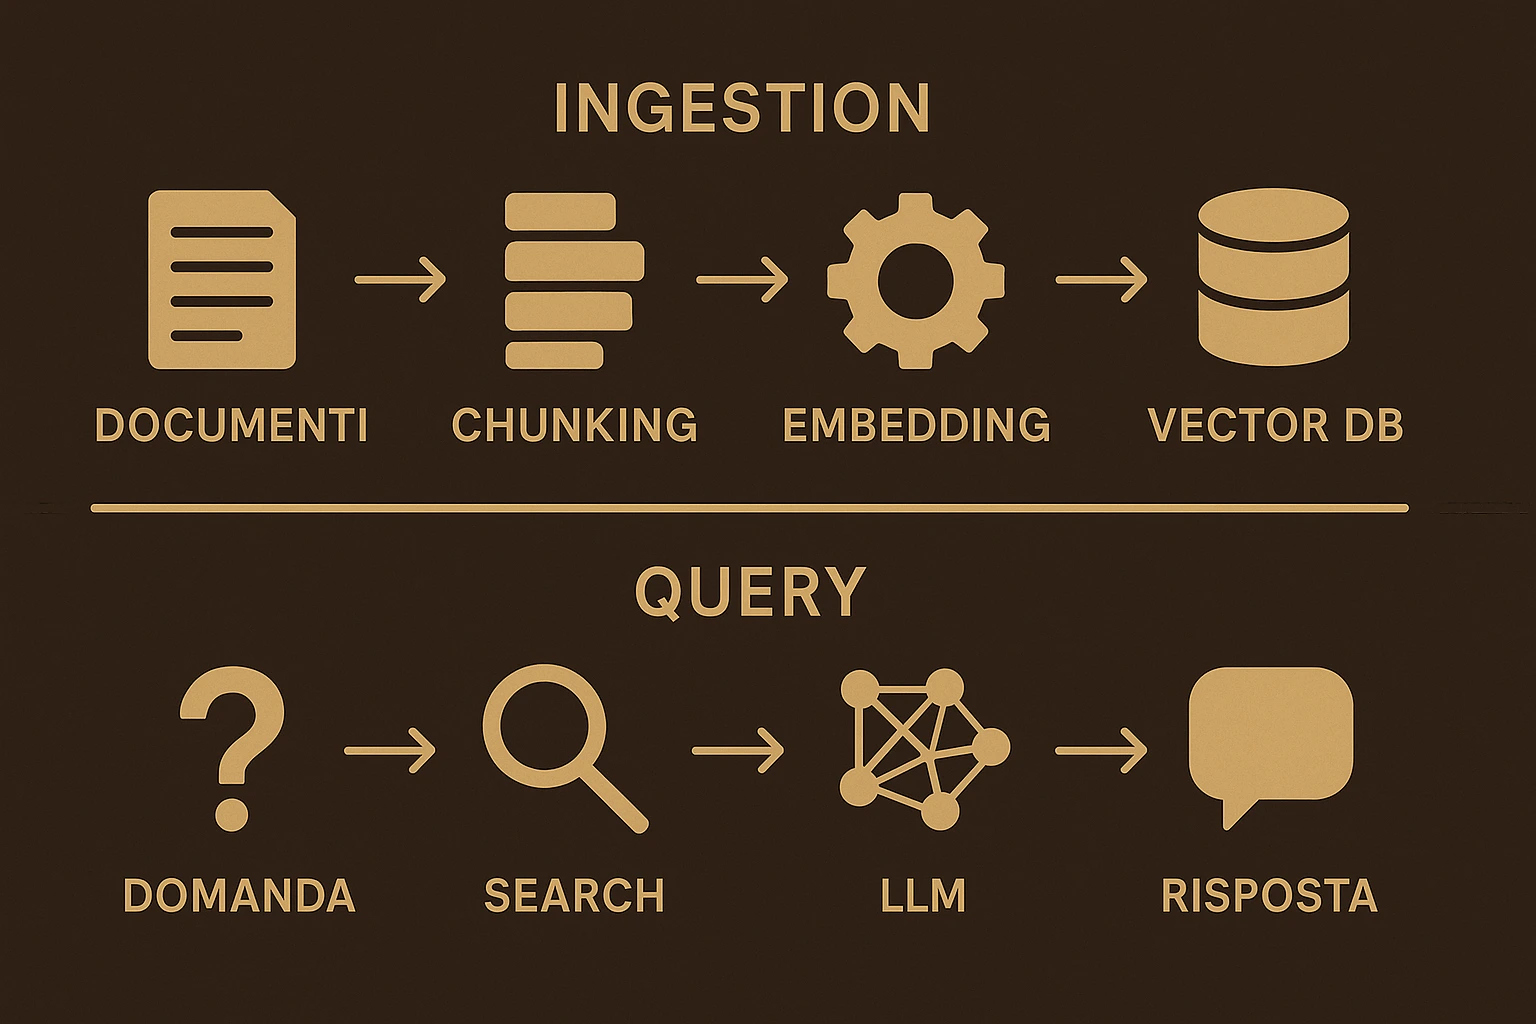
Fase 1: Ingestion (offline)
Questa fase si fa una volta sola (e poi ad ogni aggiornamento dei documenti):
Chunking è il primo passo critico. Non puoi dare un documento di 50 pagine all'embedding model — devi spezzarlo in pezzi. La dimensione ottimale è 200-500 token con un overlap del 10-20% tra chunk adiacenti. L'overlap serve a non tagliare il contesto nel punto sbagliato.
Embedding trasforma ogni chunk in un vettore numerico. Se hai letto l'articolo sugli embeddings, sai come funziona. Usi un modello come text-embedding-3-small di OpenAI, voyage-3 di Voyage AI, o jina-embeddings-v3 (open source). L'importante: lo stesso modello deve essere usato sia per i documenti che per le query.
Vector Database salva i vettori e permette ricerche veloci per similitudine. Pinecone, Qdrant, Chroma, o anche pgvector se hai già PostgreSQL.
Fase 2: Query (runtime)
Quando l'utente fa una domanda, il sistema esegue l'embedding della query (con lo stesso modello della fase 1), cerca i chunk più simili nel vector database, e passa query + chunk recuperati al LLM.
Il prompt che arriva al modello somiglia a questo:
Rispondi alla domanda basandoti SOLO sul contesto fornito.

CONTESTO:
[Chunk 1: "### Configurazione JWT: Installa jsonwebtoken con npm..."]
[Chunk 2: "La nostra policy di autenticazione richiede token con scadenza 24h..."]
[Chunk 3: "Per il refresh token, usa un endpoint separato /api/auth/refresh..."]

DOMANDA: Come configuro JWT nel nostro backend?
Il modello non sta "ricordando" come si configura JWT. Sta leggendo la tua documentazione specifica e rispondendo sulla base di quella. Meno spazio per le allucinazioni, più risposte accurate.
Il Dilemma del Chunking
Se il retrieval è il cuore di RAG, il chunking è il suo tallone d'Achille. Harrison Chase, CEO di LangChain, è stato chiaro: "Where RAG fails more often than not is probably in the retrieval step". E il retrieval dipende direttamente da come hai tagliato i documenti.
Chunk troppo piccoli: perdi il contesto. Un chunk che dice "Usa il metodo authenticate()" senza dire di quale classe o libreria parla è inutile.
Chunk troppo grandi: diluisci il segnale con rumore. Un chunk di 2000 token che parla di autenticazione, autorizzazione, rate limiting e logging — il modello deve capire quale parte è rilevante per la domanda.
Lo sweet spot nel 2026 è 200-500 token con overlap 10-20%. Ma il trend è verso il chunking semantico: invece di tagliare a finestra fissa, si analizza il contenuto e si taglia dove il significato cambia. È più costoso computazionalmente, ma produce chunk più coerenti.
# Chunking a finestra fissa (naive)
chunks = [text[i:i+500] for i in range(0, len(text), 400)]  # 500 char window, 100 overlap

# Chunking semantico (avanzato) - pseudocodice
chunks = []
for paragraph in split_by_meaning(text):
    if len(paragraph) > 500:
        chunks.extend(split_preserving_sentences(paragraph, max_tokens=500))
    else:
        chunks.append(paragraph)
Naive, Advanced, Agentic: Tre Livelli di RAG
Non tutti i sistemi RAG sono uguali. Nel 2026 si parla di tre livelli di sofisticazione.
Naive RAG
La pipeline base: chunk, embed, store, retrieve, generate. Nessun reranking, chunk a finestra fissa, nessuna ottimizzazione. Funziona per prototipi e PoC. Se stai esplorando RAG per la prima volta, parti da qui.
Advanced RAG
Aggiunge le ottimizzazioni che fanno la differenza in produzione:
- Hybrid search: combina vector similarity con keyword search (BM25). I vettori catturano il significato, BM25 cattura le corrispondenze esatte — insieme coprono più casi
- Reranking: un secondo modello riordina i risultati del retrieval per rilevanza. Anthropic ha dimostrato che aggiungere reranking riduce il tasso di fallimento del retrieval del 67% (dal 5.7% all'1.9%)
- Contextual retrieval: tecnica di Anthropic che aggiunge contesto a ogni chunk prima dell'embedding. Invece di embeddare "Usa il metodo authenticate()", embeddi "Questo chunk proviene dalla documentazione del modulo Auth di Express.js. Usa il metodo authenticate()"
- Query transformation: riscrivere la query dell'utente per migliorare il retrieval
Agentic RAG
Il livello più avanzato. Un agente LLM decide come e quando fare retrieval. Non è più un workflow fisso — è un loop dove il modello pianifica più step di ricerca, sceglie tra diversi tool, e riflette sui risultati intermedi.
L'agente non segue un workflow fisso — decide autonomamente quando e come cercare nuove informazioni, quale tool usare, e se i risultati sono sufficienti.
| Scenario | Approccio consigliato |
|---|---|
| Prototipo / PoC | Naive RAG |
| Produzione con dati strutturati | Advanced RAG |
| Query complesse multi-step | Agentic RAG |
| Knowledge base < 500 pagine | Prompt diretto (no RAG) |
| Knowledge base > 500 pagine | RAG obbligatorio |
Il dato sulle 500 pagine viene da Anthropic: per collezioni sotto i 200.000 token (~500 pagine), inserire il contenuto direttamente nel prompt è spesso più efficace di una pipeline RAG.
RAG vs Fine-Tuning: Quando Serve Cosa
Questa è la domanda che tutti fanno. La risposta breve: dipende da cosa vuoi ottenere.
Fine-tuning modifica i pesi del modello. Gli insegni un nuovo stile, un nuovo dominio, un nuovo comportamento. Il modello "impara" — ma non può essere aggiornato facilmente e non sai esattamente cosa ha memorizzato.
RAG non tocca il modello. Gli dà contesto esterno al momento della query. Puoi aggiornare i documenti in qualsiasi momento senza ri-addestrare nulla. E puoi vedere esattamente quali documenti hanno generato la risposta.
I numeri parlano chiaro:
| Approccio | Vantaggio | Note |
|---|---|---|
| LLM base | Nessuna personalizzazione | Allucinazioni frequenti su dati specifici |
| Solo fine-tuning | Stile e dominio | Costoso in GPU, non aggiornabile facilmente |
| Solo RAG | Fatti e documenti | Semplice, aggiornabile, trasparente |
| Fine-tuning + RAG | Il meglio di entrambi | Approccio ibrido raccomandato in produzione |
Il pattern raccomandato nel 2026: RAG per i fatti, fine-tuning per lo stile. Vuoi che il modello risponda con il tono aziendale e conosca i termini del tuo dominio? Fine-tuning. Vuoi che abbia accesso alla documentazione aggiornata? RAG. Vuoi entrambi? Ibrido.
Jerry Liu ha un punto importante sulla trasparenza: "RAG increases transparency, visibility into the actual documents that are getting fed into their context". Con RAG puoi implementare access control sui dati — l'utente A vede certi documenti, l'utente B altri. Con il fine-tuning è impossibile: la conoscenza è fusa nei pesi.
Il Problema "Lost in the Middle"
C'è un limite strutturale che ogni sistema RAG deve affrontare. Liu et al. (Stanford/UC Berkeley, 2023) hanno dimostrato che gli LLM ignorano le informazioni posizionate al centro del context window.
La performance segue una curva a U: alta per le informazioni all'inizio e alla fine del contesto, bassa per quelle nel mezzo. È il "Lost in the Middle" problem — confermato anche su modelli con 128K+ token di context window.
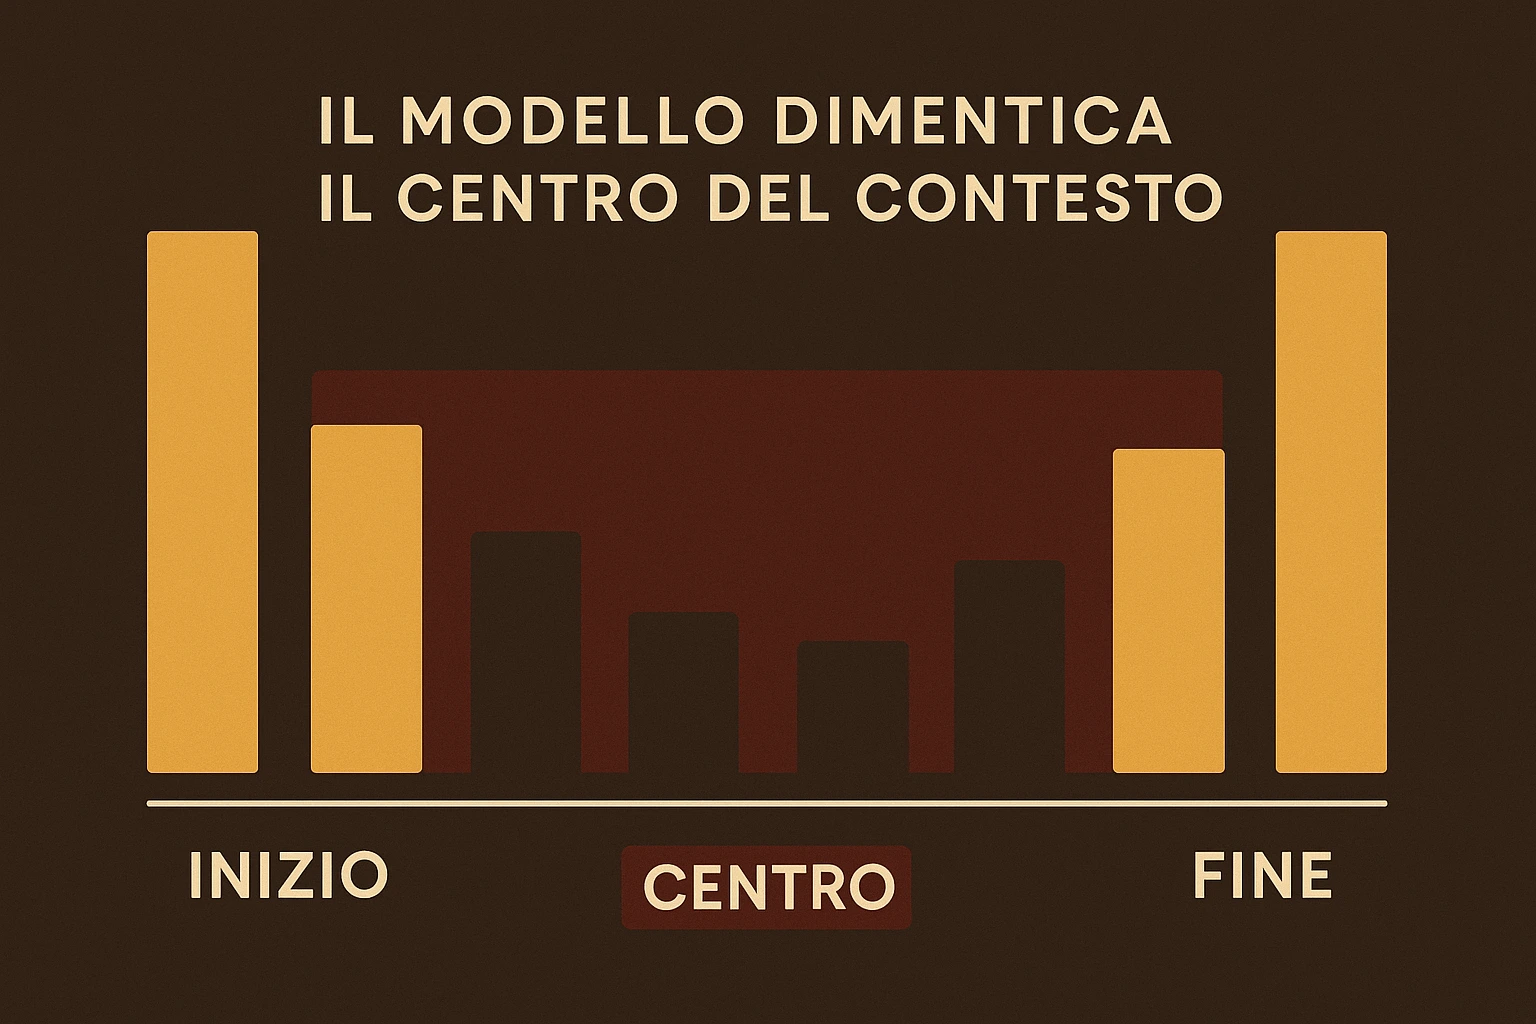
La causa è un positional attention bias: il meccanismo di attention presta più attenzione alle posizioni iniziali e finali. Se il chunk più rilevante finisce al centro di 20 chunk recuperati, il modello potrebbe non usarlo.
Le soluzioni pratiche:
- Riordinare i documenti: metti le informazioni cruciali in cima o in fondo — è gratis
- Two-stage retrieval: prima recupera molti candidati, poi un reranker seleziona i migliori
- Compressione del prompt: strumenti come LongLLMLingua (LlamaIndex) comprimono il contesto rimuovendo le parti ridondanti
- Meno chunk, più rilevanti: meglio 5 chunk precisi che 20 vaghi
Lo Stai Già Usando (Senza Saperlo)
Se usi Cursor, Claude Code, GitHub Copilot o qualsiasi IDE AI, stai usando RAG. Ogni volta che l'agente "legge" il tuo codebase per rispondere a una domanda, sta eseguendo una pipeline RAG:
- Il tuo codebase viene indicizzato (chunking dei file, embedding)
- La tua domanda viene trasformata in un vettore
- I file più rilevanti vengono recuperati
- Il modello genera la risposta usando quei file come contesto
Cursor lo chiama "codebase indexing". Claude Code lo fa con il grafo dei file. Copilot con il suo retrieval interno. Il nome cambia, il pattern è sempre RAG.
E non è solo per il codice. Notion AI usa RAG sul tuo workspace. Perplexity usa RAG su internet. ChatGPT con browsing usa una forma di RAG. Il pattern è ovunque perché funziona — è la soluzione più pragmatica al problema della conoscenza limitata degli LLM.
Cosa Sta Cambiando: Da RAG a Context Engine
Il termine "RAG" nel 2026 sta diventando stretto. Il pattern si sta evolvendo in qualcosa di più ampio: il Context Engine.
Non si tratta più solo di recuperare documenti. Un context engine moderno gestisce tre tipi di retrieval:
- Domain knowledge: la RAG tradizionale — documenti, wiki, codebase
- Tool retrieval: trovare l'API o il servizio giusto da chiamare
- Memory retrieval: la storia della conversazione e lo stato dell'agente
Harrison Chase sintetizza il tutto: "When agents mess up, they mess up because they don't have the right context; when they succeed, they succeed because they have the right context." RAG non è più un pattern isolato — è la componente di retrieval dentro un sistema agente.
Le frontiere aperte:
GraphRAG costruisce un grafo entità-relazione sul corpus documentale. Permette risposte su temi globali dove RAG standard (che recupera frammenti puntuali) fatica. Ma ha problemi pratici: l'entity extraction consuma molti più token del testo originale, e le entità estratte contengono rumore significativo.
Multimodal RAG recupera e ragiona su testo, immagini e video. È ancora in fase di prototipazione — il bottleneck sono gli indici tensoriali che creano costi di storage a scala TB.
Context window sempre più grandi (1M+ token) potrebbero rendere RAG meno necessario per knowledge base piccole. Ma per chi lavora con milioni di documenti, non c'è context window che tenga.
Implicazioni Pratiche per Chi Sviluppa
Se stai valutando RAG per un progetto, ecco le regole operative:
Parti naive, poi ottimizza. Non costruire un sistema Advanced RAG al giorno uno. Parti con chunk fissi, un embedding model standard, e Chroma o pgvector. Misura. Se il retrieval non è abbastanza buono, aggiungi hybrid search e reranking.
Il retrieval è tutto. Se il retrieval fallisce, la risposta sarà sbagliata — non importa quanto sia potente il tuo LLM. Investi tempo nel chunking e nella qualità dell'embedding prima di ottimizzare il prompt.
Misura le allucinazioni. Non fidarti delle demo. Crea un test set di domande con risposte note e verifica sistematicamente. Il tasso di allucinazione è la metrica che conta.
Sotto 500 pagine, pensa due volte. Se la tua knowledge base è piccola, il prompt diretto (o il long context) potrebbe funzionare meglio di una pipeline RAG completa. Meno componenti = meno cose che possono rompersi.
I costi sono gestibili. L'embedding è economico: Voyage AI costa $0.06 per milione di token. Il retrieval aggiunge 10-50ms di latenza per query. Lo storage vettoriale scala con i documenti, ma per la maggior parte dei progetti non è un problema.
RAG è un hack. Ma è il tipo di hack su cui puoi costruire un prodotto. Funziona, scala, e ti dà il controllo sui dati che il fine-tuning non può darti. Inizia semplice, misura, e itera.
Fonti:
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (NeurIPS 2020)
- Liu et al. — Lost in the Middle: How Language Models Use Long Contexts (2023)
- Anthropic — Contextual Retrieval
- Meta AI — RAG Research Publication
- VentureBeat — Harrison Chase (LangChain) on RAG Failures
- Sequoia Capital — Harrison Chase on Context Engineering
- Latent Space — Jerry Liu "RAG is a hack"
- MarketsandMarkets — RAG Market Report
- RAGFlow — Year-End Review 2025: From RAG to Context
- Vercel AI SDK — RAG Chatbot Guide
- Cension AI — RAG vs Fine-Tuning: Costs and Hallucinations