Word2Vec: L'Idea che Ha Cambiato Tutto
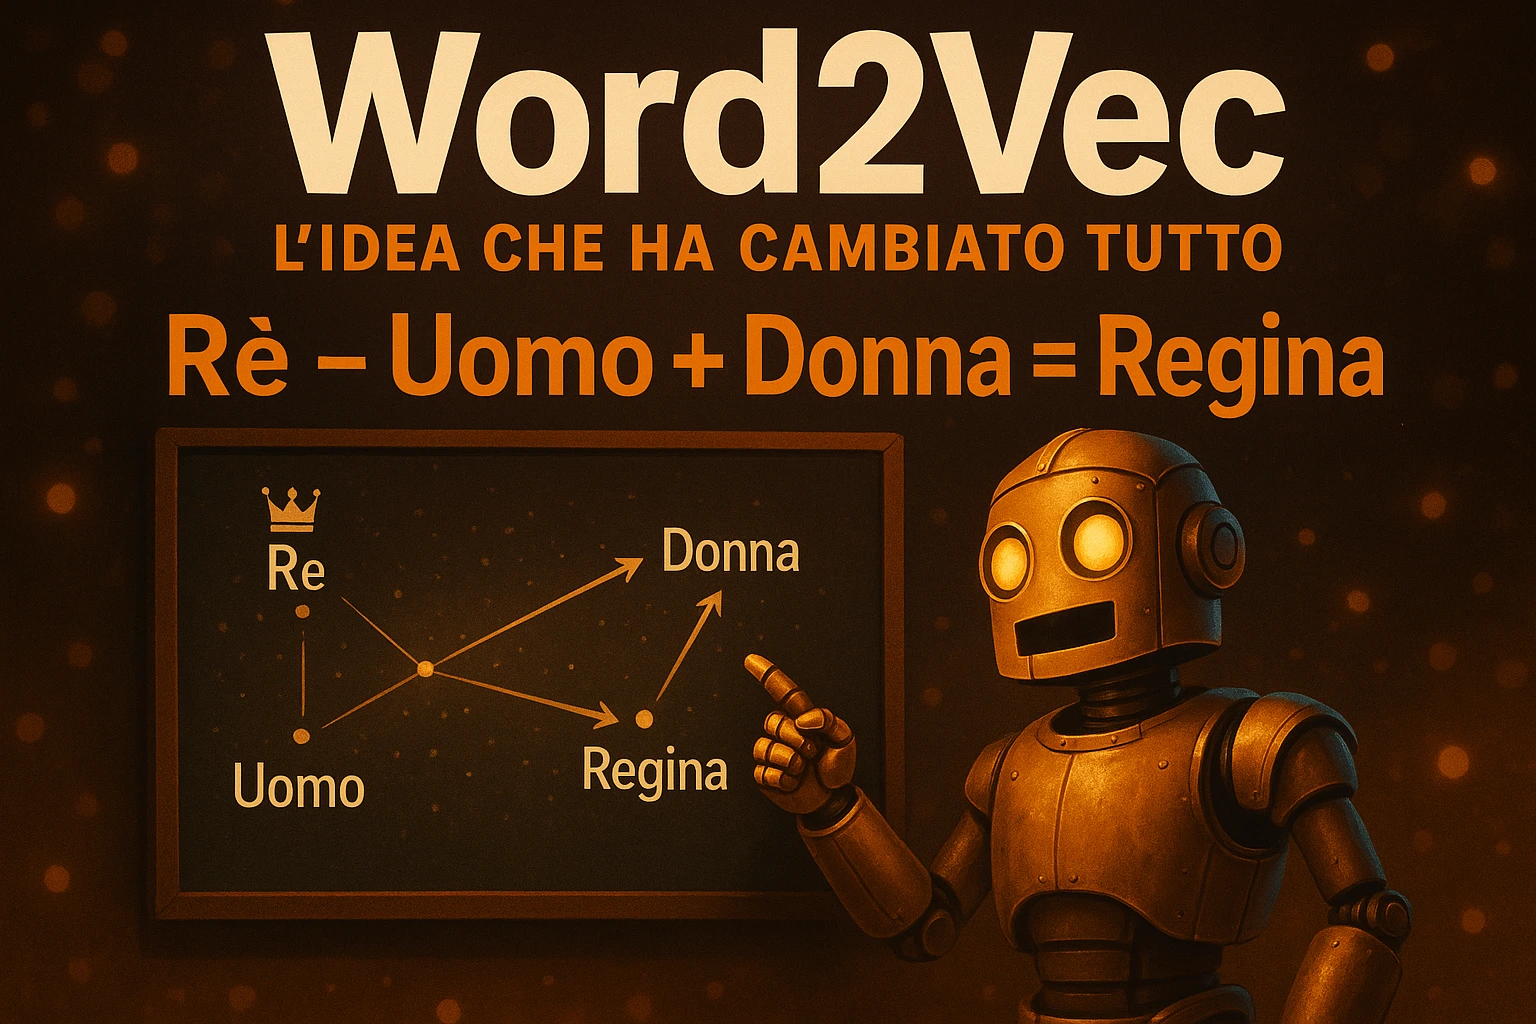
Word2Vec ha insegnato ai computer che 're - uomo + donna = regina' trasformando le parole in vettori. L'idea del 2013 alla base di ogni LLM moderno.
Alessandro Saiani
Human in the Loop
Nel 2013, un ricercatore ceco di nome Tomas Mikolov ha pubblicato un paper mentre lavorava a Google. Il paper è stato rifiutato alla conferenza ICLR con voti "strong reject" — nonostante quell'anno ICLR accettasse il 70% dei lavori sottomessi.
Oggi quel paper ha 37.000+ citazioni. Probabilmente più di tutti i paper accettati a ICLR 2013 messi insieme.
L'idea era semplice: e se trasformassimo le parole in numeri — non numeri qualsiasi, ma coordinate in uno spazio matematico dove la distanza tra i punti rappresenta la distanza di significato?
Quell'idea si chiama Word2Vec, e ha cambiato tutto. Ogni volta che usi ChatGPT, Claude, Copilot o qualsiasi LLM, la prima cosa che succede è esattamente quella: le tue parole vengono trasformate in vettori. È il DNA di tutta l'intelligenza artificiale moderna.
Il Problema: Come Fa un Computer a "Capire" una Parola?
Per un computer, "gatto" è una sequenza di caratteri: g-a-t-t-o. Non sa che è un animale. Non sa che è simile a "cane". Non sa che è diverso da "automobile".
Prima di Word2Vec: One-Hot Encoding
Il modo tradizionale di rappresentare le parole era il one-hot encoding. In un vocabolario di 100.000 parole, ogni parola è un vettore di 100.000 numeri — tutti zero tranne uno.
gatto      = [0, 0, 0, ..., 1, ..., 0, 0, 0] (100.000 numeri)
cane       = [0, 0, 1, ..., 0, ..., 0, 0, 0] (100.000 numeri)
automobile = [0, 1, 0, ..., 0, ..., 0, 0, 0] (100.000 numeri)
Il problema è evidente: in questa rappresentazione, "gatto" è equidistante da "cane" e da "automobile". Non c'è nessuna informazione semantica. Per il computer sono solo tre slot diversi in una tabella enorme.
L'Intuizione di Word2Vec: Vettori Densi
Word2Vec comprime quei 100.000 numeri in 300 numeri — ma numeri reali, non zero e uno. Ogni numero cattura una sfumatura di significato.
gatto      = [0.21, -0.45, 0.83, ..., 0.12]  (300 numeri)
cane       = [0.19, -0.41, 0.79, ..., 0.15]  (300 numeri)
automobile = [-0.67, 0.33, -0.12, ..., 0.88] (300 numeri)
Adesso "gatto" e "cane" hanno numeri simili — sono vicini nello spazio. "Automobile" è lontana. Il computer non "capisce" ancora cosa sia un gatto, ma sa che gatto e cane sono più simili tra loro che gatto e automobile.
E questo basta per fare cose incredibili.
L'Ipotesi che Fa Funzionare Tutto
Il fondamento teorico viene dal linguista britannico J.R. Firth, che nel 1957 scrisse:
"You shall know a word by the company it keeps." (Conoscerai una parola dalla compagnia che tiene.)
L'idea: le parole che compaiono negli stessi contesti tendono ad avere significati simili.
Pensa a queste frasi:
- "Il gatto dorme sul divano"
- "Il cane dorme sul divano"
- "Il gatto mangia dalla ciotola"
- "Il cane mangia dalla ciotola"
"Gatto" e "cane" compaiono nelle stesse frasi, accanto alle stesse parole. Word2Vec sfrutta esattamente questo: non guarda cosa una parola significa, ma dove compare. E da lì ne deduce il significato.
Come Funziona: Due Architetture
Word2Vec ha due modi di imparare, entrambi basati su una rete neurale superficiale — non deep learning, solo 1-2 strati. La semplicità è il punto di forza.
CBOW: Indovina la Parola dal Contesto
Continuous Bag of Words: date le parole intorno, predici quella al centro.
Frase: "Il veloce gatto marrone salta"
- Contesto (finestra di 2): "Il", "veloce", "marrone", "salta"
- Parola da indovinare: "gatto"
Il modello prende i vettori delle parole di contesto, li media, e usa quel vettore medio per predire la parola centrale. Poi aggiusta i pesi per migliorare la prossima predizione.
Punto di forza: è più veloce e funziona meglio con parole frequenti.
Skip-gram: Indovina il Contesto dalla Parola
L'opposto. Data una parola, predici quelle intorno.
Stessa frase: "Il veloce gatto marrone salta"
- Parola in input: "gatto"
- Parole da indovinare: "Il", "veloce", "marrone", "salta"
Il modello prende il vettore di "gatto" e cerca di predire ciascuna parola di contesto indipendentemente.
Punto di forza: funziona meglio con parole rare e vocabolari piccoli.
La Finestra che Scorre
In entrambi i casi, una finestra scorre sulla frase parola per parola:
Frase: "Il gatto nero dorme sul divano caldo"

Passo 1: [Il] [gatto] [NERO] [dorme] [sul]      → centro: nero
Passo 2: [gatto] [nero] [DORME] [sul] [divano]  → centro: dorme
Passo 3: [nero] [dorme] [SUL] [divano] [caldo]  → centro: sul
Finestra tipica: 4 parole per lato. Su miliardi di frasi, il modello vede ogni parola in migliaia di contesti diversi — e impara a posizionarla nel punto giusto dello spazio vettoriale.
Negative Sampling: Il Trucco che Ha Reso Tutto Possibile
Il problema originale: per ogni parola, il modello doveva calcolare una probabilità su tutto il vocabolario (milioni di parole). Troppo lento.
La soluzione di Mikolov: negative sampling. Invece di confrontare con tutte le parole del vocabolario:
- Prendi la coppia reale: ("gatto", "dorme") — campione positivo
- Genera 5-10 coppie casuali: ("gatto", "frigorifero"), ("gatto", "parlamento") — campioni negativi
- Insegna al modello a distinguere le coppie vere da quelle false
Risultato: invece di aggiornare milioni di pesi per ogni passo, ne aggiorni circa 1.800 — lo 0.06% del totale. L'addestramento passa da settimane a ore.
La Magia: Aritmetica con le Parole
Ecco il risultato che ha fatto il giro del mondo.
Nello spazio vettoriale di Word2Vec, puoi fare operazioni matematiche con i significati:
Re - Uomo + Donna = Regina
vec("re") - vec("uomo") + vec("donna") ≈ vec("regina")
Cosa sta succedendo? Sottraendo "uomo" da "re" estrai il concetto di regalità. Aggiungendo "donna" ottieni la versione femminile: "regina".
Non è programmato. Nessuno ha detto al modello che re e regina sono legati. Lo ha imparato da solo, leggendo testi.
Altri Esempi (con parole italiane)
Relazioni geografiche — "capitale di":
Roma - Italia + Francia ≈ Parigi
Tokyo - Giappone + Germania ≈ Berlino
Relazioni grammaticali — tempo verbale:
mangiare - mangiato + dormire ≈ dormito
correre - correndo + leggere ≈ leggendo
Relazioni di genere:
fratello - uomo + donna ≈ sorella
attore - uomo + donna ≈ attrice
Relazioni comparative:
grande - più grande + piccolo ≈ più piccolo
buono - migliore + cattivo ≈ peggiore
Come Funziona Geometricamente
I vettori che collegano coppie con la stessa relazione sono paralleli. La freccia da "uomo" a "donna" punta nella stessa direzione della freccia da "re" a "regina". Questa direzione è il concetto di genere, codificato come una direzione nello spazio matematico.
Un dettaglio che pochi menzionano: nell'implementazione reale, le parole di input vengono escluse dalla ricerca dei risultati. Senza questo filtro, "re - uomo + donna" restituirebbe "re" come risultato più vicino, non "regina".
I Numeri del Paper Originale
Il modello pre-addestrato rilasciato da Google:
| Parametro | Valore |
|---|---|
| Corpus di addestramento | ~100 miliardi di parole (Google News) |
| Vocabolario | 3 milioni di parole e frasi |
| Dimensioni per vettore | 300 |
| File del modello | 1.5 GB |
Accuratezza sulle Analogie
I test hanno misurato la capacità di completare analogie tipo "A sta a B come C sta a ?":
| Tipo di relazione | Accuratezza |
|---|---|
| Comparativi (buono:migliore :: cattivo:?) | 91.7% |
| Superlativi (buono:ottimo :: cattivo:?) | 87.9% |
| Plurali (mano:mani :: piede:?) | 89.6% |
| Tempo passato (camminare:camminato :: nuotare:?) | 67.1% |
| Capitali (Italia:Roma :: Giappone:?) | Alto |
Velocità di Addestramento
| Configurazione | Accuratezza totale | Tempo |
|---|---|---|
| CBOW 300 dim, 1.6B parole | 36.1% | 0.6 giorni |
| Skip-gram 300 dim, 1.6B parole | 53.8% | 2 giorni |
| Skip-gram 1000 dim, 6B parole | 65.6% | 2.5 giorni × 125 core |
Per confronto, i modelli neurali precedenti (NNLM) richiedevano 14 giorni × 180 core per risultati peggiori. Word2Vec era ordini di grandezza più efficiente.
I Limiti: Cosa Non Sa Fare
Word2Vec ha un difetto fondamentale: ogni parola ha un solo vettore, indipendentemente dal contesto.
Il Problema della Polisemia
La parola "pesca" ha almeno tre significati:
- "La pesca è un frutto dolce" (frutto)
- "Andiamo a pesca al lago" (attività)
- "La pesca dei numeri al lotto" (estrazione)
Word2Vec genera un unico vettore per "pesca" — una media confusa di tutti i significati. Non sa distinguere quale intendi.
Lo stesso vale per:
- "banco": mobile scolastico vs istituto finanziario vs banco di nebbia
- "campo": agricolo vs sportivo vs scientifico
- "nota": musicale vs appunto vs famosa
Altri Limiti
- Nessuna comprensione della frase: Word2Vec lavora parola per parola, non capisce il significato complessivo
- Parole fuori vocabolario: se una parola non era nel corpus di addestramento, non esiste vettore per lei
- Nessuna morfologia: "correre", "correndo", "corse", "corridore" sono parole completamente separate
- Bias nei dati: Word2Vec impara e amplifica i pregiudizi presenti nei testi di addestramento (es: "programmatore" più vicino a "uomo" che a "donna")
L'Evoluzione: Da Word2Vec ai Modelli di Oggi
Word2Vec è il capostipite. Tutto ciò che è venuto dopo lo ha migliorato, ma l'intuizione di base — significato come posizione nello spazio — è rimasta invariata.
| Anno | Modello | Innovazione | Tipo |
|---|---|---|---|
| 2013 | Word2Vec | Parole come vettori densi | Statico |
| 2014 | GloVe (Stanford) | Combina statistiche globali + contesto locale | Statico |
| 2016 | FastText (Facebook) | Sotto-parole: risolve il problema delle parole sconosciute | Statico |
| 2018 | ELMo (Allen NLP) | Primo embedding contestuale: vettori diversi per contesti diversi | Contestuale |
| 2018 | BERT (Google) | Transformer bidirezionale: capisce il contesto in entrambe le direzioni | Contestuale |
| 2018+ | GPT (OpenAI) | Transformer generativo: predice il token successivo, scala a miliardi di parametri | Contestuale |
| 2024+ | text-embedding-3 (OpenAI) | Embedding moderni con dimensionalità variabile e istruzioni | Contestuale |
Il salto fondamentale è tra statico e contestuale:
- Statico (Word2Vec, GloVe, FastText): un vettore fisso per ogni parola, calcolato una volta
- Contestuale (ELMo, BERT, GPT, Claude): il vettore cambia in base alla frase — "pesca" ha un vettore diverso a seconda che parli di frutta o di attività sportiva
Ma la base è la stessa. Quando Claude legge il tuo messaggio, la prima operazione è un embedding lookup — convertire ogni token in un vettore denso. Esattamente come Word2Vec, solo più grande, più profondo, e contestuale.
Perché Ti Riguarda
Se sei uno sviluppatore che usa l'AI, capire Word2Vec significa capire il layer fondamentale di ogni strumento che usi.
Perché la ricerca semantica funziona? Perché le parole con significato simile hanno vettori vicini — il principio di Word2Vec.
Perché i vector database esistono? Perché gli embedding (discendenti diretti di Word2Vec) possono essere indicizzati e cercati per similarità.
Perché il RAG funziona? Perché puoi trasformare documenti in vettori e trovare quelli "più vicini" alla domanda dell'utente.
Perché Claude capisce che "sviluppatore" e "programmatore" sono sinonimi? Perché nello spazio degli embedding sono punti vicini.
Tutto questo viene da un ricercatore ceco che ha lottato per sei mesi con la burocrazia di Google per poter rilasciare il codice open source. Quando finalmente ci è riuscito, nell'agosto 2013, il mondo se ne è accorto.
300 numeri per parola. Un'idea semplice. L'inizio di tutto.
Fonti e approfondimenti:
- Mikolov et al. - Efficient Estimation of Word Representations in Vector Space (2013) — Il paper originale
- Mikolov et al. - Distributed Representations of Words and Phrases (NeurIPS 2013) — Paper sul negative sampling (NeurIPS Test of Time Award 2023)
- Chris McCormick - Word2Vec Tutorial — Guida pratica al modello pre-addestrato
- Lena Voita - NLP Course: Word Embeddings — Spiegazione visuale eccellente
- David Strohmaier - 10 Years of Word2Vec — Retrospettiva a 10 anni
- Stanford NLP - GloVe Project — L'alternativa di Stanford
- MIT Technology Review - King - Man + Woman = Queen — L'analogia più famosa