L'Agente Che Impara Dai Propri Errori
Reflexion porta GPT-4 dall'80% al 91%. Voyager è 15x più veloce. AlphaEvolve ha ottimizzato Google. Ma l'AI si auto-migliora davvero? I 3 livelli spiegati.
Alessandro Saiani
Human in the Loop
80% su HumanEval. È il punteggio di GPT-4 quando gli chiedi di scrivere codice al primo tentativo. Rispettabile, ma non esaltante. Ora prendi lo stesso modello, dagli la possibilità di riflettere sui propri errori, e il numero sale al 91%. Stessi pesi, stessa architettura, zero fine-tuning. L'unica differenza: un loop che dice al modello "hai sbagliato, pensa a cosa è andato storto."
Quel salto — dall'80% al 91% — è il dato più importante che troverai oggi sul self-improvement degli agenti AI. Non perché sia il più grande, ma perché sfata il mito più diffuso: no, l'agente non "diventa più intelligente". Diventa più bravo a usare l'intelligenza che già ha.
E questa distinzione è tutto.
I tre livelli del self-improvement
Il problema con il termine "auto-miglioramento" è che mette nello stesso calderone cose radicalmente diverse. Un agente che corregge un bug nella stessa sessione, un file di memoria che persiste tra sessioni, e un sistema che riscrive la propria architettura neurale — sono tre cose che condividono un nome ma non condividono quasi nient'altro.
Per capire cosa funziona davvero, servono tre livelli distinti.
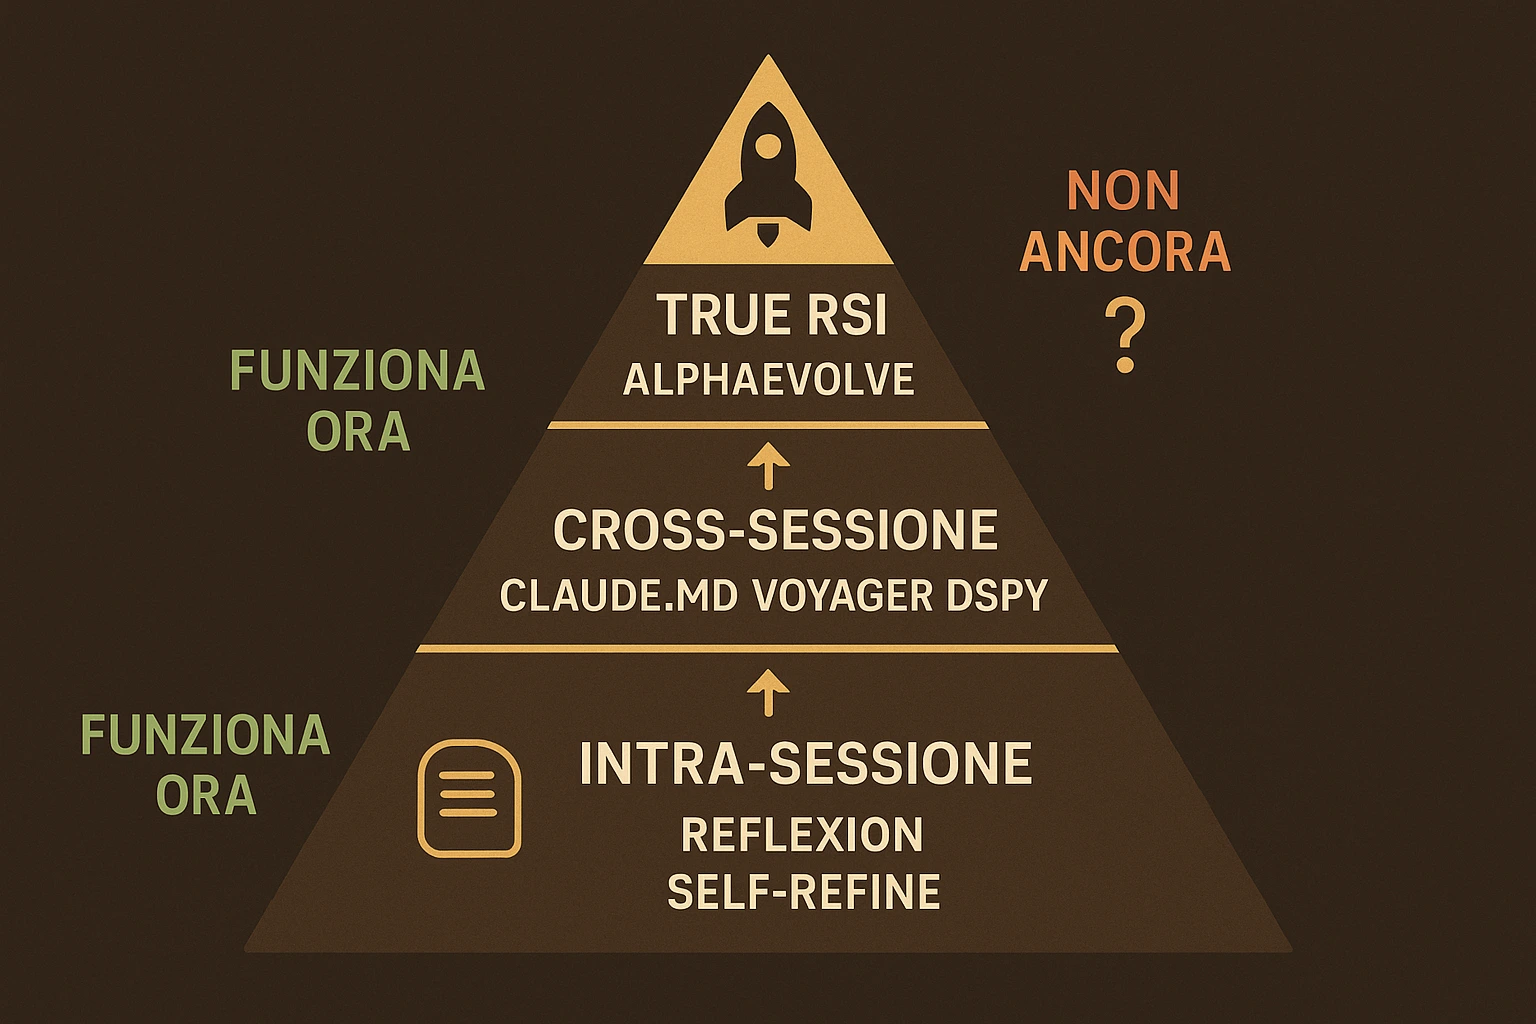
| Aspetto | Intra-sessione | Cross-sessione | True RSI |
|---|---|---|---|
| Meccanismo | Riflessione verbale, retry | Memory files, skill library | Modifica propri pesi |
| Persistenza | Una sessione | Tra sessioni | Permanente |
| Pesi del modello | Frozen | Frozen | Si auto-aggiornano |
| Verifica | Test o umano | Umano | Autonoma |
| Stato | Funziona ora | Funziona con limiti | Non ancora realizzato |
Livello 1: Intra-sessione — il loop che già funziona
Questo è il livello più maturo e il più sottovalutato. L'idea è semplice: invece di chiedere all'agente una risposta secca, gli dai la possibilità di sbagliare, riflettere, e riprovare.
Reflexion (Shinn et al., NeurIPS 2023) è il paper che ha formalizzato il concetto. L'agente mantiene una "memoria episodica" testuale — una lista di errori passati e lezioni apprese — e la consulta prima di ogni nuovo tentativo. Su HumanEval, il benchmark standard per la generazione di codice, il risultato è quel 91% vs 80% del baseline. Su ALFWorld e HotpotQA, miglioramenti altrettanto significativi.
Self-Refine (Madaan et al., NeurIPS 2023) porta il concetto ancora più in là. Lo stesso LLM genera l'output, si auto-critica, e lo raffina. Nessun modello esterno, nessun training aggiuntivo. Il risultato: +20% assoluto in media su 7 task diversi — dialogo, ragionamento matematico, generazione di codice. E bastano 4 iterazioni per raggiungere il plateau.
Il pattern è lo stesso che vedi nei modelli reasoning come o1 e o3 di OpenAI. La chain-of-thought estesa è, nella sostanza, una forma di self-correction: il modello genera un ragionamento, riconosce un errore logico, fa marcia indietro, riprova. Il loop ReAct — penso, agisco, osservo — è il framework che tiene tutto insieme.
Ma c'è un limite strutturale: è effimero. Quando la sessione finisce, tutto sparisce. Al prossimo restart, l'agente riparte da zero. Ha imparato a non fare lo stesso errore dentro la sessione, ma non lo ricorda tra sessioni.
È come un chirurgo brillante che ogni mattina dimentica tutte le operazioni fatte il giorno prima. L'abilità c'è. La memoria no.
Livello 2: Cross-sessione — ricordare tra le sessioni
Se il Livello 1 è il riflesso, il Livello 2 è la memoria. L'agente accumula conoscenza che persiste oltre la singola sessione.
L'esempio più concreto per chi sviluppa è CLAUDE.md. Claude Code identifica cose utili imparate durante una sessione — comandi di build, pattern di debugging, preferenze di stile — e le scrive in un file di memoria. Alla sessione successiva, quel file è nel contesto. L'agente non ripete gli stessi errori, non richiede le stesse informazioni. Un meccanismo semplice, quasi banale, ma efficace.
Cursor fa qualcosa di simile con le Memories: fatti estratti dalle conversazioni che vengono applicati in sessioni future. Devin 2.0 mantiene contesto cross-sessione e ha registrato un +83% di task completati rispetto alla versione precedente.
Ma il caso più spettacolare resta Voyager (Wang et al., ICLR 2025). È un agente in Minecraft che esplora il mondo, acquisisce skill, e le salva in una libreria di codice eseguibile. Ogni skill è una funzione JavaScript (via l'API Mineflayer) che l'agente può richiamare in futuro. Il risultato: 15.3x più veloce sui milestones del tech tree rispetto ai metodi precedenti. Le skill composte si accumulano senza catastrophic forgetting — perché non sono nei pesi del modello, sono codice.
Poi c'è DSPy, il framework di Stanford che porta il concetto a un livello più sistematico. Invece di ottimizzare prompt a mano, definisci moduli e metriche, e l'ottimizzatore compila automaticamente prompt migliori. Lancia il programma centinaia di volte, raccoglie le tracce con punteggio alto, genera istruzioni e few-shot examples ottimali. Costo pratico: 100-500 chiamate LLM, $20-50, 10-30 minuti. Il risultato: pipeline ottimizzate senza toccare i pesi del modello.
Il punto chiave è proprio questo: i pesi sono frozen. In tutti questi sistemi — CLAUDE.md, Voyager, DSPy, Cursor — il modello base non cambia. Cambia il contesto, cambiano i prompt, cambia la libreria di skill. L'agente non diventa "più intelligente". Diventa "meglio configurato". La differenza è enorme, e capirla è la differenza tra aspettative realistiche e allucinazioni — non del modello, le tue.
Livello 3: True RSI — il sogno che non è ancora realtà
Il Recursive Self-Improvement — un agente che modifica i propri pesi, la propria architettura, e diventa genuinamente più capace — è il livello di cui tutti parlano e nessuno ha raggiunto.
AlphaEvolve (Google DeepMind, 2025) è ciò che più ci si avvicina. Un agente di coding evolutivo che usa Gemini per progettare e ottimizzare algoritmi. I risultati sono impressionanti: ha recuperato lo 0.7% delle risorse compute globali di Google con un'euristica che è in produzione da oltre un anno. Ha ottenuto un 32.5% di speedup su FlashAttention. Ha migliorato l'algoritmo di Strassen del 1969 per la moltiplicazione matriciale.
Ma — e qui sta il punto — AlphaEvolve non migliora se stesso. Migliora altri sistemi. È un agente che ottimizza algoritmi esterni, non la propria architettura. La distinzione è sottile ma fondamentale: è un martello molto buono, non un martello che si affila da solo.
Karpathy AutoResearch racconta una storia simile. Uno script Python di 630 righe che dà a un agente AI un file di training e una metrica obiettivo. L'agente modifica il codice, lancia training brevi, valuta, tiene o scarta, ripete. 700 esperimenti in 2 giorni, 11% speedup nel training di un piccolo LLM. Tobi Lutke, CEO di Shopify: 19% performance gain dopo una notte di auto-ricerca. Potente, ma l'agente sta ottimizzando un altro modello, non se stesso.
SPIN (Self-Play Fine-Tuning) è forse il caso più vicino al True RSI: il modello gioca contro versioni precedenti di se stesso, genera dati di training dalla propria distribuzione, e impara a distinguere le proprie risposte da quelle umane. Risultato: +10% su GSM8k. Ma il processo richiede supervisione umana, hardware dedicato, e produce miglioramenti incrementali, non esponenziali.
L'ICLR 2026 ha dedicato il primo workshop interamente a RSI. La citazione di apertura è significativa: "Recursive self improvement is no longer a speculative vision. It is becoming a concrete systems problem." Non un breakthrough — un problema da risolvere. E un problema da risolvere non è un problema risolto.
"Ma l'agente diventa PIÙ intelligente?"
La risposta onesta: no. Non nel senso che intendiamo noi.
Dean W. Ball, su Hyperdimensional, ha scritto l'analisi più lucida sulla questione. Distingue tra self-improvement incrementale — ottimizzazione dentro paradigmi esistenti, l'ottimizzazione dentro un paradigma noto — e self-improvement paradigmatico — capacità radicalmente nuove, il salto a un paradigma diverso. Il 2026 vede solo il primo tipo.
Il collo di bottiglia, secondo Ball, non è tecnico ma concettuale: "The other deficit of the models is in the generation of interesting hypotheses and research agendas." I modelli sanno ottimizzare quello che gli dici di ottimizzare. Non sanno decidere cosa vale la pena ottimizzare. Mancano del giudizio strategico che separa un tecnico competente da un ricercatore che apre nuove strade.
Yann LeCun è più diretto: l'idea che gli LLM possano raggiungere l'auto-miglioramento ricorsivo genuino è, nelle sue parole, "nonsense." Servono architetture completamente nuove.
Dario Amodei è all'estremo opposto — prevede AI che sostituiranno il lavoro di tutti i software developer entro un anno. Ma anche nella sua visione più ottimista, il self-improvement attuale è un processo supervisionato: umani che definiscono obiettivi, metriche, guardrail.
La verità sta nel mezzo, ed è più utile di entrambi gli estremi. I sistemi di memoria attuali funzionano. Le tecniche di riflessione producono miglioramenti misurabili. Ma i pesi restano frozen, e il salto dall'ottimizzazione di parametri alla generazione di insight genuinamente nuovi non è stato fatto.
Cosa puoi fare ORA
Basta teoria. Se domani vuoi usare il self-improvement nel tuo lavoro, ecco cosa funziona.
Struttura il feedback loop. Il pattern più semplice e più efficace: fai generare codice all'agente, esegui i test, passa i risultati (errori inclusi) all'agente, fai rigenerare. Reflexion in pratica. La differenza tra un agente che genera codice e un agente che genera codice buono è spesso solo un ciclo di feedback con test automatici.
Usa i memory file. Se lavori con Claude Code, il sistema auto-memory è già attivo. Ma puoi potenziarlo: documenta esplicitamente pattern di errore ricorrenti, comandi specifici del progetto, decisioni architetturali. L'agente li userà nelle sessioni successive. È il Livello 2 alla portata di tutti.
Considera DSPy per pipeline ripetitive. Se hai una pipeline LLM che gira centinaia di volte — classificazione, estrazione dati, summarization — DSPy può ottimizzare automaticamente i prompt. Non è magia: sono $20-50 e 30 minuti di compilazione. Ma il risultato è una pipeline che funziona meglio senza che tu abbia toccato un prompt.
Il pattern AutoResearch per ottimizzazione. Se hai una metrica chiara e un parametro da ottimizzare, il pattern di Karpathy è replicabile: definisci metrica, dai all'agente il file da modificare, fai girare N iterazioni, tieni il meglio. Non serve un framework complesso — servono un obiettivo misurabile e la pazienza di lasciar girare l'agente durante la notte.
Non dimenticare il costo umano. Più loop di feedback significano più output da validare. E validare output AI è cognitivamente costoso. Il self-improvement dell'agente non ti libera dalla supervisione — la intensifica. Progetta i tuoi loop con circuit breaker: limiti hard sul numero di iterazioni, soglie sotto le quali l'agente si ferma e chiede aiuto.
Il vero rischio non è l'intelligence explosion
Il rischio concreto del self-improvement agentico non è la superintelligenza che sfugge al controllo. È qualcosa di più banale e più immediato: la fiducia mal riposta.
Un agente che si auto-corregge sembra più affidabile. Ha fatto quattro iterazioni, ha passato i test, ha raffinato l'output. Ma Self-Refine funziona bene dove ci sono metriche oggettive — codice che compila, test che passano, numeri che tornano. Nei domini soggettivi — architetture, scelte di design, copy — la self-correction può convergere verso output plausibili ma sbagliati. L'agente diventa più fluido, non più corretto.
I Self-Challenging Agents (NeurIPS 2025) raddoppiano le performance su tool-use generando i propri test. SICA passa dal 17% al 53% su SWE-Bench Verified creando casi di test che sfidano le proprie soluzioni. Ma entrambi funzionano perché il dominio ha verificatori puliti. Dove il verificatore non c'è — e nella maggior parte del lavoro reale non c'è — il self-improvement rischia di essere self-deception.
Anthropic lo sa, e la sua Responsible Scaling Policy definisce livelli crescenti di capacità AI in R&D, con safeguard corrispondenti. Il principio è chiaro: più un modello si avvicina alla capacità di accelerare autonomamente lo sviluppo AI, più servono guardrail stringenti. Non ci siamo ancora — ma il fatto che qualcuno stia definendo i confini dice che il territorio si avvicina.
Per chi sviluppa, la lezione pratica è questa: usa il self-improvement dove hai metriche chiare. Dove non le hai, il loop di feedback più importante resta quello tra l'agente e te. Non quello tra l'agente e se stesso.
Fonti:
- Shinn et al. — Reflexion: Language Agents with Verbal Reinforcement Learning (NeurIPS 2023)
- Madaan et al. — Self-Refine: Iterative Refinement with Self-Feedback (NeurIPS 2023)
- Wang et al. — Voyager: An Open-Ended Embodied Agent with LLMs (ICLR 2025)
- AlphaEvolve — Google DeepMind Blog
- Chen et al. — SPIN: Self-Play Fine-Tuning (ICML 2024)
- Karpathy — AutoResearch (GitHub)
- DSPy — Stanford NLP
- Yohei Nakajima — Better Ways to Build Self-Improving AI Agents
- Dean W. Ball — On Recursive Self-Improvement (Hyperdimensional)
- ICLR 2026 Workshop on Recursive Self-Improvement
- Anthropic — Responsible Scaling Policy
- Claude Code — Memory Documentation
- OpenAI — Learning to Reason with LLMs