Memory Systems: Come l'AI Ricorda (e Dimentica)
Context window, CLAUDE.md, MemGPT: come funziona la memoria negli agenti AI, perché dimenticano, e perché a volte dimenticare è la scelta migliore. Con architetture reali.
Alessandro Saiani
Human in the Loop
Claude Code ha un file chiamato MEMORY.md. ChatGPT costruisce un dossier su di te. Cursor legge .cursorrules. Windsurf traccia ogni tuo edit in tempo reale. Quattro approcci diversi, stesso problema: come far ricordare cose a qualcosa che dimentica tutto ogni volta che chiudi la sessione.
Se hai letto i primi due articoli di questa serie — cos'è un agente AI e come funziona il loop ReAct — sai che un agente è un while loop che pensa, agisce e osserva. Ma c'è un dettaglio che quei due articoli danno per scontato: tra un giro e l'altro del loop, l'agente deve ricordare cosa ha fatto. E tra una sessione e l'altra, deve ricordare chi sei.
La memoria è il pezzo che trasforma un tool usa-e-getta in un collaboratore che migliora nel tempo. Ed è anche il collo di bottiglia più sottovalutato dell'intera architettura.
L'Analogia con la Memoria Umana
Negli anni '60, Atkinson e Shiffrin hanno proposto un modello della memoria umana che i neuroscienziati usano ancora oggi. Ha tre livelli: la memoria sensoriale (tutto ciò che percepisci), la memoria a breve termine (ciò che tieni in mente in questo momento, circa 7 elementi), e la memoria a lungo termine (tutto ciò che hai consolidato nel tempo).
Il parallelo con un agente AI è sorprendentemente preciso.
La memoria sensoriale è l'input: il prompt che scrivi, i file che carichi, le immagini che incolli. Dati grezzi che arrivano al sistema.
La memoria a breve termine è la context window. Limitata, volatile, selettiva. Come la short-term memory di Atkinson-Shiffrin — che tiene circa 7 elementi in un umano (Miller, 1956) — la context window di un LLM tiene N token e poi basta. Quello che non ci sta viene perso.
La memoria a lungo termine vive nei pesi del modello. È conoscenza consolidata durante il training, come i ricordi che si formano durante il sonno. Lenta da modificare, difficile da aggiornare, ma persistente.
E poi c'è il quarto pezzo, quello che non ha equivalente biologico diretto: la memoria esterna. File, database, vector store. Il taccuino dello studente che non memorizza tutto, ma sa dove trovare le cose. I file CLAUDE.md, le memorie di ChatGPT, i vector database di RAG — tutti rientrano qui.
Un bravo studente non cerca di memorizzare un intero libro. Sa quali capitoli rileggere e dove ha messo i suoi appunti. Un buon agente dovrebbe fare lo stesso. Ma per ora, la maggior parte non ci riesce.
I Cinque Tipi di Memoria
La tassonomia moderna degli agenti AI, proposta da Hu et al. nel paper "Memory in the Age of AI Agents" del 2025, distingue la memoria per forma, funzione e dinamica. Per chi sviluppa, la distinzione più utile è quella funzionale — cinque tipi che ricalcano la psicologia cognitiva.
| Tipo di Memoria | Equivalente Umano | Equivalente AI | Esempio Pratico |
|---|---|---|---|
| Working memory | Ciò che tieni in mente adesso | Context window | La conversazione corrente con Claude Code |
| Semantica | Fatti e relazioni | Knowledge base, pesi del modello | "L'utente preferisce TypeScript" |
| Episodica | Esperienze specifiche | Cronologia sessioni passate | "Ieri ha fixato un bug in auth.ts" |
| Procedurale | Come fare le cose | Pesi + codice dell'agente | Come eseguire un refactoring |
| Parametrica | Conoscenza implicita | Pesi del modello (training) | Sapere la sintassi di Python |
La memoria procedurale è la più sottile. In un umano, è andare in bicicletta — sai farlo senza pensarci. In un agente, è una combinazione dei pesi del modello (che codificano come scrivere codice) e delle istruzioni esplicite (CLAUDE.md, system prompt) che codificano come comportarsi in un contesto specifico.
LangGraph ha formalizzato questa distinzione nel suo SDK, separando memoria short-term (thread-scoped, dentro una sessione) e long-term (namespace-scoped, attraverso sessioni diverse). Le vecchie classi come ConversationBufferMemory sono state deprecate dalla v0.3 proprio perché la distinzione era troppo grossolana.
Il Problema del Contesto: Lost in the Middle
Fin qui sembra semplice. La context window è la working memory, i file esterni sono la long-term memory, e il gioco è fatto. Ma c'è un problema che rende tutto molto più complicato: la context window non funziona come pensi.
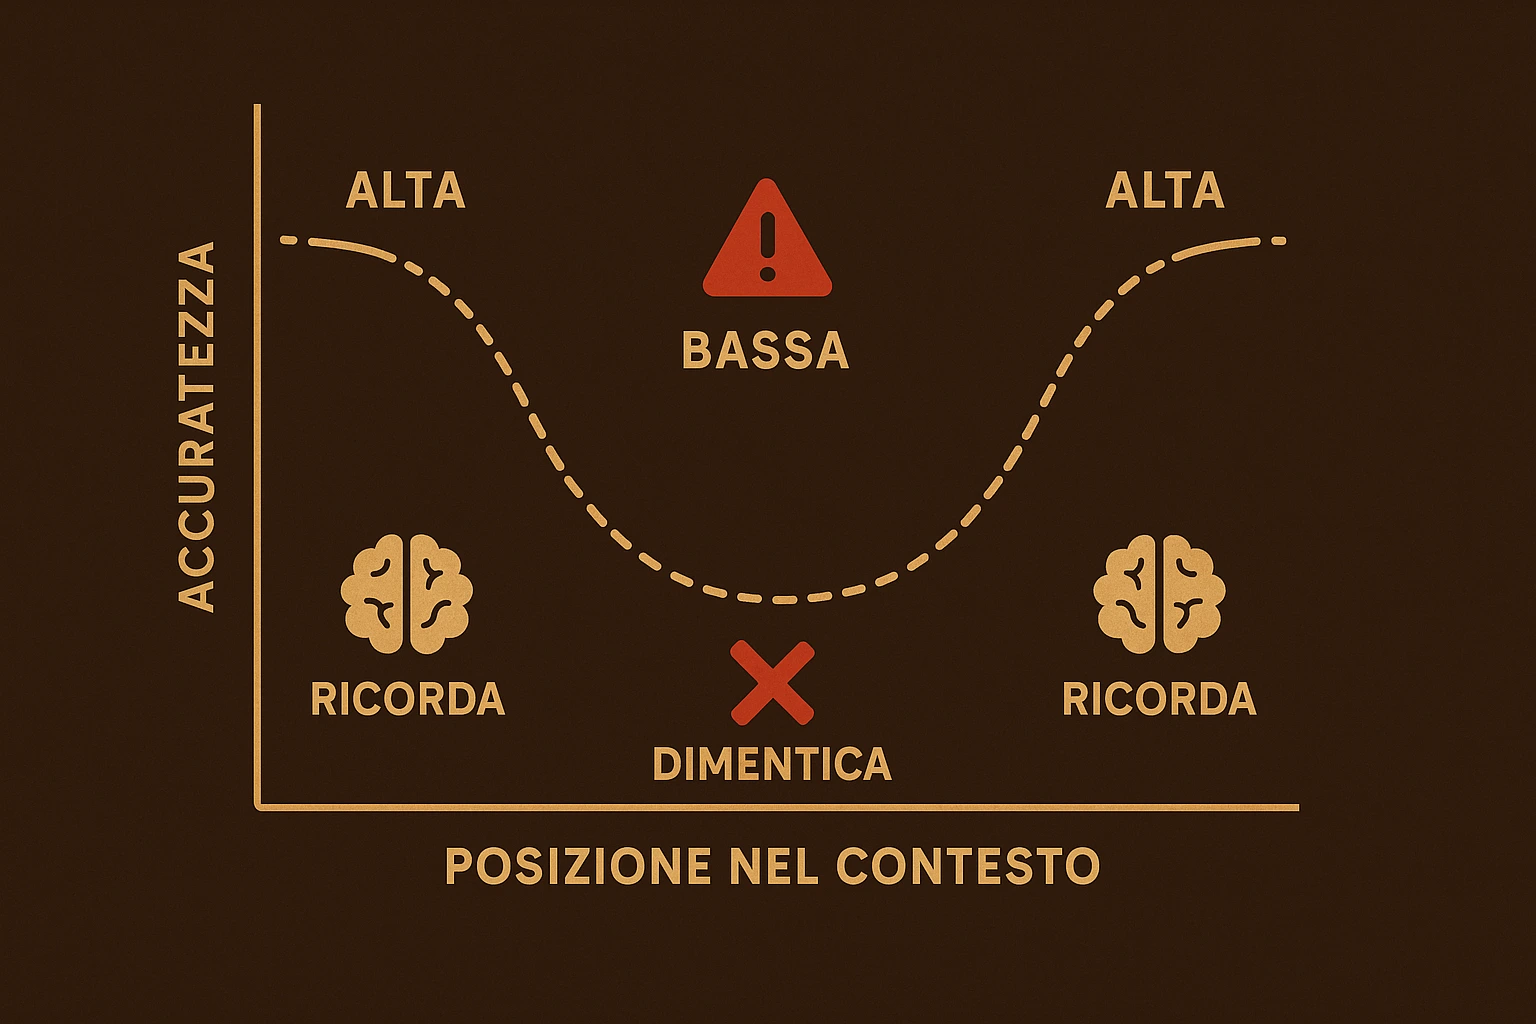
Nel 2023, Liu et al. hanno pubblicato "Lost in the Middle" — un paper che ha cambiato il modo in cui progettiamo i prompt. Il finding è brutale: quando metti 20 documenti nella context window, il modello trova l'informazione rilevante con alta accuratezza se è nel primo o nell'ultimo documento. Ma se è nel mezzo? Oltre il 30% di calo nell'accuratezza.
La performance segue una curva a U. L'inizio va bene (primacy). La fine va bene (recency). Il mezzo si perde.
È un Alzheimer selettivo. L'AI ricorda la prima cosa che le hai detto e l'ultima. Tutto quello in mezzo — dove spesso ci sono le decisioni architetturali, i requisiti intermedi, i dettagli critici — evapora.
E il problema non si risolve semplicemente allargando la finestra.
Context Rot: Più Grande Non Significa Migliore
Se "Lost in the Middle" è il problema posizionale, il "Context Rot" è il problema dimensionale. Chroma Research ha testato 18 LLM — GPT-4.1, Claude 4, Gemini 2.5, Qwen3 — e ha trovato che le performance degradano consistentemente con l'aumento della lunghezza dell'input, anche su task semplici.
Il 10.000-esimo token non è gestito con la stessa affidabilità del 100-esimo. Non importa quanto sia grande la finestra.
I numeri attuali delle context window sono impressionanti: Llama 4 Scout arriva a 10 milioni di token, Gemini 3.1 Ultra a 2 milioni, Claude Opus 4.6 a 1 milione. Ma ecco il dato che i marketing deck non riportano: un modello che dichiara 200K token diventa tipicamente inaffidabile intorno a 130K. La degradazione non è graduale — è improvvisa.
C'è anche un paradosso strutturale affascinante: i modelli funzionano meglio con input shufflati (incoerenti) che con quelli logicamente strutturati. L'attention mechanism risponde in modo diverso alla struttura dell'input man mano che la lunghezza cresce. Controintuitivo, ma dimostrato.
E il benchmark Sequential-NIAH del 2025 mette il punto: anche il miglior modello raggiunge massimo il 63.50% di accuratezza quando deve trovare più informazioni distribuite in un contesto lungo. Il classico needle-in-a-haystack — trovare un singolo fatto nascosto — è un test troppo semplice. Il mondo reale chiede di ricordare molte cose contemporaneamente.
Se vuoi approfondire il tema del contesto e cosa vede realmente l'AI, è un argomento che merita un articolo a sé.
Come Claude Code Ricorda
Claude Code ha l'architettura di memoria più esplicita tra gli agenti di coding mainstream. È stratificata su quattro livelli, e la puoi ispezionare interamente — nessuna scatola nera.
Primo livello: CLAUDE.md. File Markdown che l'utente scrive e che Claude carica a ogni sessione. Ce ne sono quattro, gerarchici: globale (~/.claude/CLAUDE.md), di progetto (/progetto/CLAUDE.md), di directory (/progetto/frontend/CLAUDE.md), personale (.local.md, gitignored). Sono istruzioni esplicite: "usa TypeScript strict", "i test vanno in /tests/", "non toccare i file in /legacy/". Più sono corti, meglio funzionano — perché occupano meno context window.
Secondo livello: Auto Memory. Claude scrive da solo un file MEMORY.md dove accumula lezioni tra sessioni. Comandi di build che ha scoperto, pattern architetturali che ha osservato, preferenze di stile che ha dedotto. Le prime 200 righe o i primi 25KB vengono caricati a inizio sessione. Il resto esiste ma non viene letto a meno che Claude non lo cerchi esplicitamente.
Terzo livello: la conversazione. La cronologia della sessione corrente, che vive nella context window. Ogni messaggio, ogni output di tool, ogni risultato di grep. Qui sta il problema.
Quarto livello: Compaction. Quando il contesto si avvicina al limite (il trigger è configurabile, di default circa 150K token), Claude Code attiva un auto-compact. Riassume la conversazione: prima cancella gli output dei tool più vecchi, poi sintetizza i messaggi. È una forma di dimenticanza controllata. Ma "controllata" è un eufemismo — la compattazione può perdere decisioni architetturali importanti se non la guidi. La best practice è compattare proattivamente prima di raggiungere il limite.
Il pattern sottostante è quello che dal leak del codice sorgente è emerso come "pointer index": il MEMORY.md funziona come un indice che punta ad altri file di memoria strutturati. L'agente non tiene tutto in testa — sa dove cercare.
Come ChatGPT Ricorda
ChatGPT usa un approccio radicalmente diverso. E non è quello che la maggior parte degli utenti crede.
Un'analisi dettagliata di EmbraceTehRed ha rivelato l'architettura interna: le memorie di ChatGPT sono iniettate direttamente nel system prompt. Non c'è RAG. Non c'è vector database. Non c'è ricerca semantica. Tutto viene impacchettato nel prompt di sistema, ogni volta.
Il system prompt contiene diverse sezioni:
- Model Set Context — memorie salvate esplicitamente ("ricorda che...") con timestamp.
- Recent Conversation Content — sommari delle ultime ~40 chat (solo i messaggi dell'utente, non le risposte di ChatGPT, per risparmiare spazio).
- Assistant Response Preferences — oltre 15 pattern di interazione inferiti, con metadata di confidence. "L'utente preferisce bullet point" (alta confidence). "L'utente lavora in fintech" (media confidence).
- Notable Past Conversation Topics — 8+ sommari ad alto livello di argomenti discussi.
- Helpful User Insights — fino a 14 dettagli biografici e professionali.
Simon Willison, uno dei nomi più rispettati nella community developer, ha chiamato questo sistema un "memory dossier". Non è un archivio cercabile delle tue conversazioni — è un profilo su di te che ChatGPT costruisce nel tempo. La distinzione è importante: non ricorda cosa hai detto, ricorda chi sei (o chi pensa tu sia).
L'approccio funziona, ma ha implicazioni di privacy non banali. E ha un limite tecnico evidente: tutto quel profilo occupa spazio nella context window. Spazio che non è disponibile per il task attuale.
MemGPT: La Metafora RAM/Disco
Nel 2023, Charles Packer e colleghi hanno pubblicato "MemGPT: Towards LLMs as Operating Systems" — un paper che prende la metafora informatica più vecchia del mondo e la applica agli LLM con risultati sorprendenti.
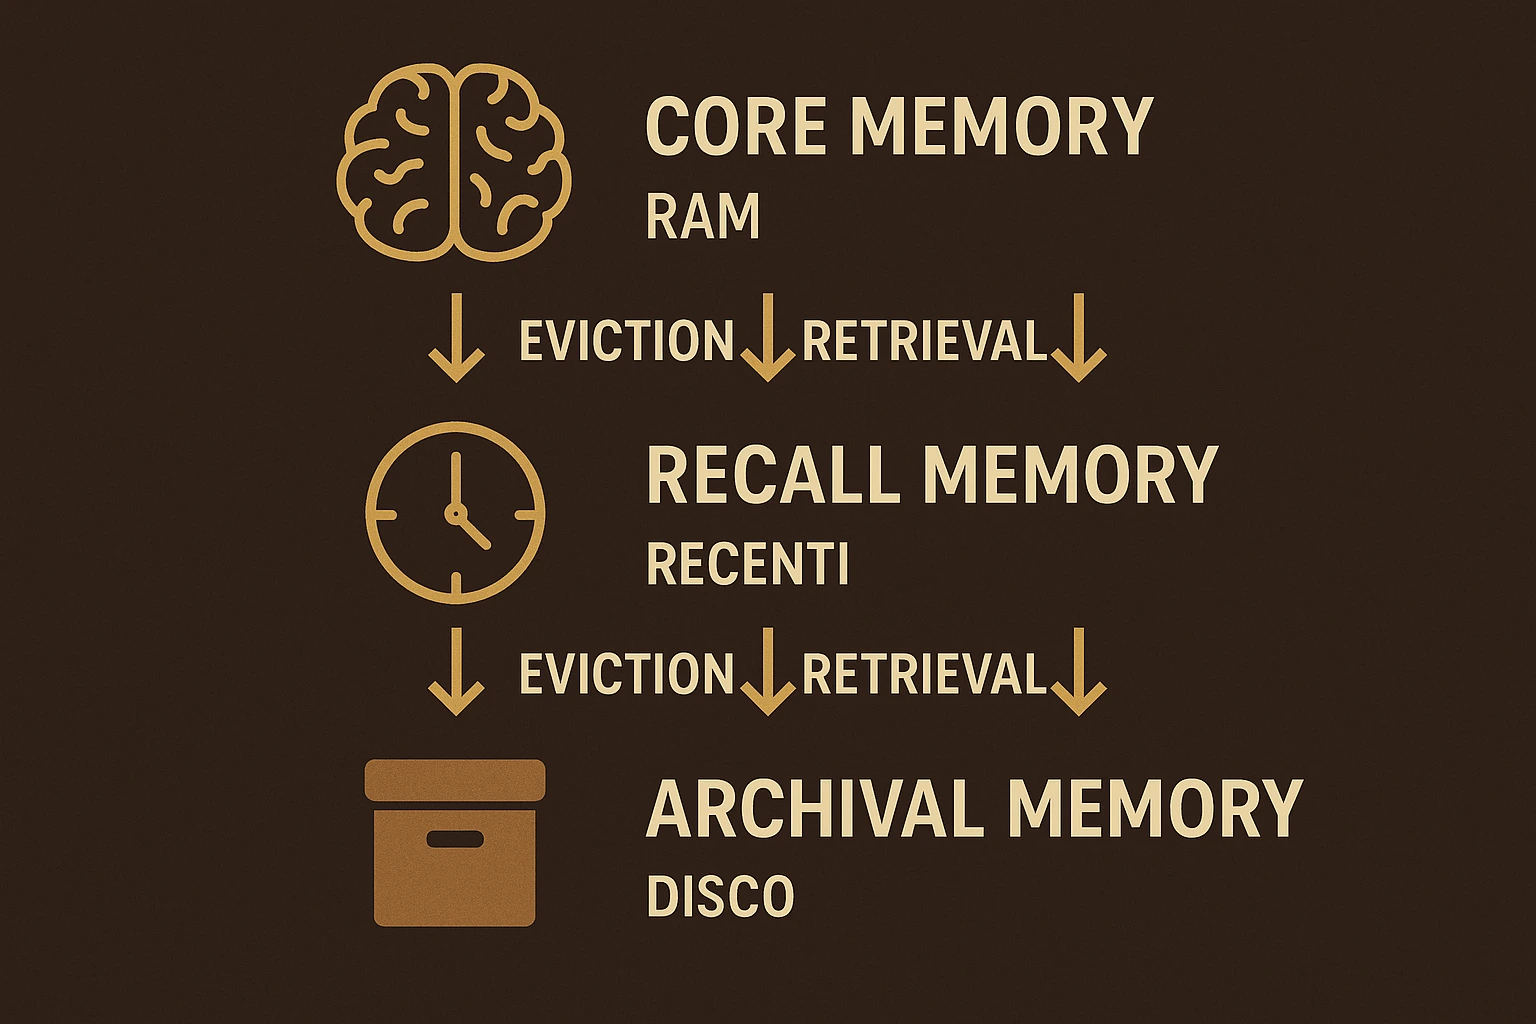
L'idea: tratta la context window come RAM e la memoria esterna come disco. Poi implementa un sistema di paging tra le due, esattamente come fa un sistema operativo.
Tre livelli di memoria:
Core Memory — sempre nella context window, come la RAM. Blocchi strutturati per topic: preferenze dell'utente, stato del task, informazioni critiche. Editabile via API, limitata ma sempre accessibile.
Recall Memory — la cronologia completa delle interazioni, salvata su disco. Cercabile on-demand, ma non presente nella context window finché non viene esplicitamente richiamata. Come il disco rigido: lento, enorme, va cercato.
Archival Memory — conoscenza esplicita in database esterni (vector DB, graph DB). Recuperata via tool calling quando serve contesto specifico.
Quando il buffer raggiunge circa il 70% della capacità, MemGPT attiva un warning di "memory pressure": il modello sintetizza i messaggi importanti e li sposta in Recall, liberando spazio nel buffer attivo. È lo swap di un OS — quando la RAM si riempie, i dati meno usati vanno su disco.
L'innovazione post-paper è il "Sleep-Time Compute": l'agente gestisce la memoria in modo asincrono durante i periodi di inattività, raffinando e organizzando i ricordi quando l'utente non sta interagendo. Come il sonno consolida i ricordi negli umani.
MemGPT è diventato Letta, un framework open-source. E il pattern ha influenzato l'intera industria — l'architettura di Claude Code, con il suo MEMORY.md come indice e la compaction come eviction, somiglia a MemGPT più di quanto Anthropic ammetterebbe.
Il Filesystem È il Nuovo Database
C'è un pattern emergente che merita attenzione, perché tre progetti indipendenti ci sono arrivati separatamente.
Manus — l'agente acquisito da Meta per 2 miliardi di dollari — usa tre file Markdown: task_plan.md (obiettivi e progresso), notes.md (ricerca), e un file di output. Niente vector database. Niente architettura distribuita. Tre file di testo.
Claude Code — MEMORY.md più file per topic, tutto in Markdown, tutto versionabile con Git.
OpenClaw — 350K+ stelle su GitHub — MEMORY.md, daily logs, SOUL.md per la personalità.
La convergenza non è casuale. I modelli sono addestrati su workflow di developer: repository, cartelle, Markdown, log, CLI. Sanno già leggere directory, fare grep, scrivere file. E il costo è imbattibile: circa $0.02/GB/mese per file su disco, contro $50-200/GB/mese per un database gestito.
Ma il vantaggio più grande è la debuggability. Un file Markdown è trasparente: lo apri con qualsiasi editor, lo leggi, lo modifichi, lo metti in version control. Un vector database è una scatola nera — se l'agente recupera il contesto sbagliato, buona fortuna a capire perché.
La filosofia è "Memory as Documentation" contro "Memory as Database". Il primo approccio tratta la memoria come documentazione nello workspace dell'utente — visibile, editabile, portatile. Il secondo la tratta come stato di sistema nascosto. Per chi lavora con agenti di coding ogni giorno, il primo funziona meglio.
Dimenticare È una Feature
Arriviamo al dato controintuitivo: troppa memoria è peggio di poca.
Context rot lo dimostra empiricamente — più contesto dai a un modello, peggio performa. Lost in the Middle lo conferma — il 30% delle informazioni nel mezzo del contesto viene ignorato. E il dato di Mem0 lo mette in prospettiva: riducendo i token dell'80-90% rispetto alla chat history completa, la qualità delle risposte migliora del 26%.
Meno contesto. Risposte migliori. Non è un paradosso — è selezione.
Un manager che legge 500 pagine di report prende decisioni peggiori di uno che legge un executive summary di 5 pagine. Non perché le 500 pagine non contengano informazioni utili, ma perché il rumore copre il segnale. Lo stesso vale per un LLM: quando la context window è piena di informazioni marginali, l'attention mechanism si disperde.
Processare 1 milione di token di contesto costa $5 con Claude Opus. Un agente che "ricorda tutto" spende ordini di grandezza in più di uno che seleziona cosa ricordare. E non solo spende di più — risponde peggio.
La compaction di Claude Code non è un compromesso tecnico. È una feature. Il memory pressure di MemGPT al 70% non è una limitazione. È design. E il fatto che ChatGPT salvi solo le ultime ~40 chat, non tutte, non è pigrizia ingegneristica — è una scelta informata.
Chi sviluppa agenti deve resistere all'istinto di "dare al modello tutto il contesto possibile". La domanda giusta non è "come faccio a far ricordare di più?" ma "come faccio a far ricordare le cose giuste?".
Se l'agente inventa cose, spesso il problema non è che ha poca memoria — è che ne ha troppa, e del tipo sbagliato.
Agenti con Ricordi: L'Esperimento di Stanford
Nel 2023, Park et al. hanno pubblicato "Generative Agents: Interactive Simulacra of Human Behavior" — un paper che ha messo 25 agenti AI in un ambiente tipo The Sims con memoria episodica completa.
Ogni agente aveva un Memory Stream: un flusso continuo di osservazioni ("ho visto Maria in biblioteca alle 14:30"), da cui il sistema estraeva riflessioni di alto livello ("Maria sta preparando un esame") e pianificava azioni future ("domani le chiederò come va lo studio").
La catena è: Osservazioni, Memory Stream, Retrieval, Riflessione, Pianificazione, Azione.
Il retrieval non era casuale: combinava recency (quanto è recente il ricordo), importanza (quanto è saliente) e rilevanza (quanto è pertinente al contesto attuale). Gli agenti non ricordavano tutto — ricordavano ciò che serviva. E gli osservatori umani giudicavano i comportamenti degli agenti come "credibilmente umani".
Quel paper ha dimostrato che la memoria episodica — ricordare esperienze specifiche, non solo fatti — è il tassello mancante per agenti che sembrano avere continuità di identità. Non solo "so che preferisci TypeScript", ma "ricordo che ieri abbiamo provato TypeScript e il linting dava problemi con la config ESLint del progetto".
È la differenza tra un collega che conosce le tue preferenze e uno che ricorda la vostra storia lavorativa insieme. Il secondo è molto più utile.
Per chi approfondisce il tema del RAG come memoria esterna, l'architettura di retrieval dei Generative Agents è un caso d'uso che va oltre il classico "cerca nei documenti".
Cosa Significa per Chi Sviluppa
La memoria non è un problema risolto. È il collo di bottiglia degli agenti AI nel 2026. E chi lo capisce prende decisioni migliori su tre fronti.
Scelta del tool. Claude Code è trasparente: puoi leggere, editare e versionare la sua memoria. ChatGPT è opaco: il dossier è nel system prompt e non hai controllo granulare su cosa contiene. Cursor indicizza con Merkle tree, Windsurf con dependency graph. Ogni tool ha una filosofia di memoria diversa. Scegli in base a quanto controllo ti serve.
Configurazione. Il CLAUDE.md corto funziona meglio di quello lungo. Le istruzioni critiche vanno all'inizio o alla fine, mai nel mezzo. La compaction va fatta proattivamente, non reattivamente. Queste non sono preferenze — sono conseguenze dirette di Lost in the Middle e Context Rot.
Architettura dei tuoi agenti. Se stai costruendo un agente, resisti alla tentazione del vector database complesso. Tre file Markdown, un buon sistema di retrieval, e una strategia di eviction chiara coprono l'80% dei casi d'uso. Il pattern "filesystem as memory" ha funzionato per Manus (acquisito per 2 miliardi), funziona per Claude Code, e probabilmente funziona per il tuo progetto.
La memoria è ciò che dà continuità all'agente. Senza di essa, ogni sessione riparte da zero. Con troppa, l'agente affoga nel rumore. Il punto di equilibrio — sapere cosa ricordare, cosa dimenticare, e dove mettere il confine — è ancora più arte che scienza.
Ma è un'arte che chi usa agenti ogni giorno deve coltivare.
Fonti:
- Hu et al. — Memory in the Age of AI Agents (arXiv, 2025)
- Liu et al. — Lost in the Middle: How Language Models Use Long Contexts (TACL 2024)
- Packer et al. — MemGPT: Towards LLMs as Operating Systems (2023)
- Park et al. — Generative Agents: Interactive Simulacra of Human Behavior (UIST '23)
- Chroma Research — Context Rot (2025-2026)
- Anthropic — Claude Code Memory
- Anthropic — Compaction
- EmbraceTehRed — How ChatGPT Memory Works (2025)
- Simon Willison — ChatGPT Memory Dossier (2025)
- Letta — Agent Memory
- LangGraph — Memory Documentation
- Elvex — Context Length Comparison 2026
- Mem0 — LLM Chat History Summarization Guide
- Arize — Agent Interfaces 2026: Filesystem vs API vs Database
- Sequential-NIAH (arXiv, 2025)