ReAct: Il Pattern Penso-Agisco-Osservo
Un ricercatore ha scritto il DNA di ogni AI agent moderno durante il dottorato. Come funziona il loop Thought-Action-Observation, perché batte sia CoT che Act-only, e dove lo usi già senza saperlo.
Alessandro Saiani
Human in the Loop
Shunyu Yao aveva 25 anni quando ha scritto il DNA di ogni AI agent che usi oggi.
Non in senso metaforico. ReAct, Tree of Thoughts, SWE-bench — come primo autore — e Reflexion come co-autore: il ragazzo ha contribuito all'intero stack teorico che sta sotto Claude Code, Cursor, Codex e qualsiasi altro agente di coding. Laureato alla Tsinghua (Yao Class), PhD a Princeton, passato da OpenAI, poi Chief AI Scientist di Tencent con un contratto da 100 milioni di yuan (~14 milioni di dollari) riportato da Bloomberg. MIT Technology Review lo ha messo tra i "35 Innovators Under 35" in Cina.
Ma il paper che ha cambiato tutto è arrivato nel 2022, quando era ancora un dottorando. Si chiama "ReAct: Synergizing Reasoning and Acting in Language Models", ed è stato accettato a ICLR 2023 come Oral presentation — top 5% dei paper sottomessi. Ha accumulato migliaia di citazioni accademiche. E il pattern che descrive è diventato talmente fondamentale da essere invisibile, come il pattern MVC nel web development.
Il Problema: Pensare Senza Agire, Agire Senza Pensare
Se hai letto l'articolo sul Chain of Thought, sai che far "pensare ad alta voce" un LLM ne migliora drasticamente le capacità. Sei parole — "Let's think step by step" — portano un modello dal 17.7% al 78.7% su problemi matematici. Il CoT è potente.
Ma ha un difetto strutturale: pensa e basta.
Il modello ragiona, costruisce catene logiche, arriva a conclusioni — tutto nella sua testa. Non verifica mai nulla contro il mondo reale. Se durante il ragionamento genera un fatto sbagliato, non ha modo di correggersi. Non può cercare su Wikipedia, non può eseguire codice, non può controllare un database. Ragiona nel vuoto. E quando ragioni nel vuoto, le hallucination sono inevitabili.
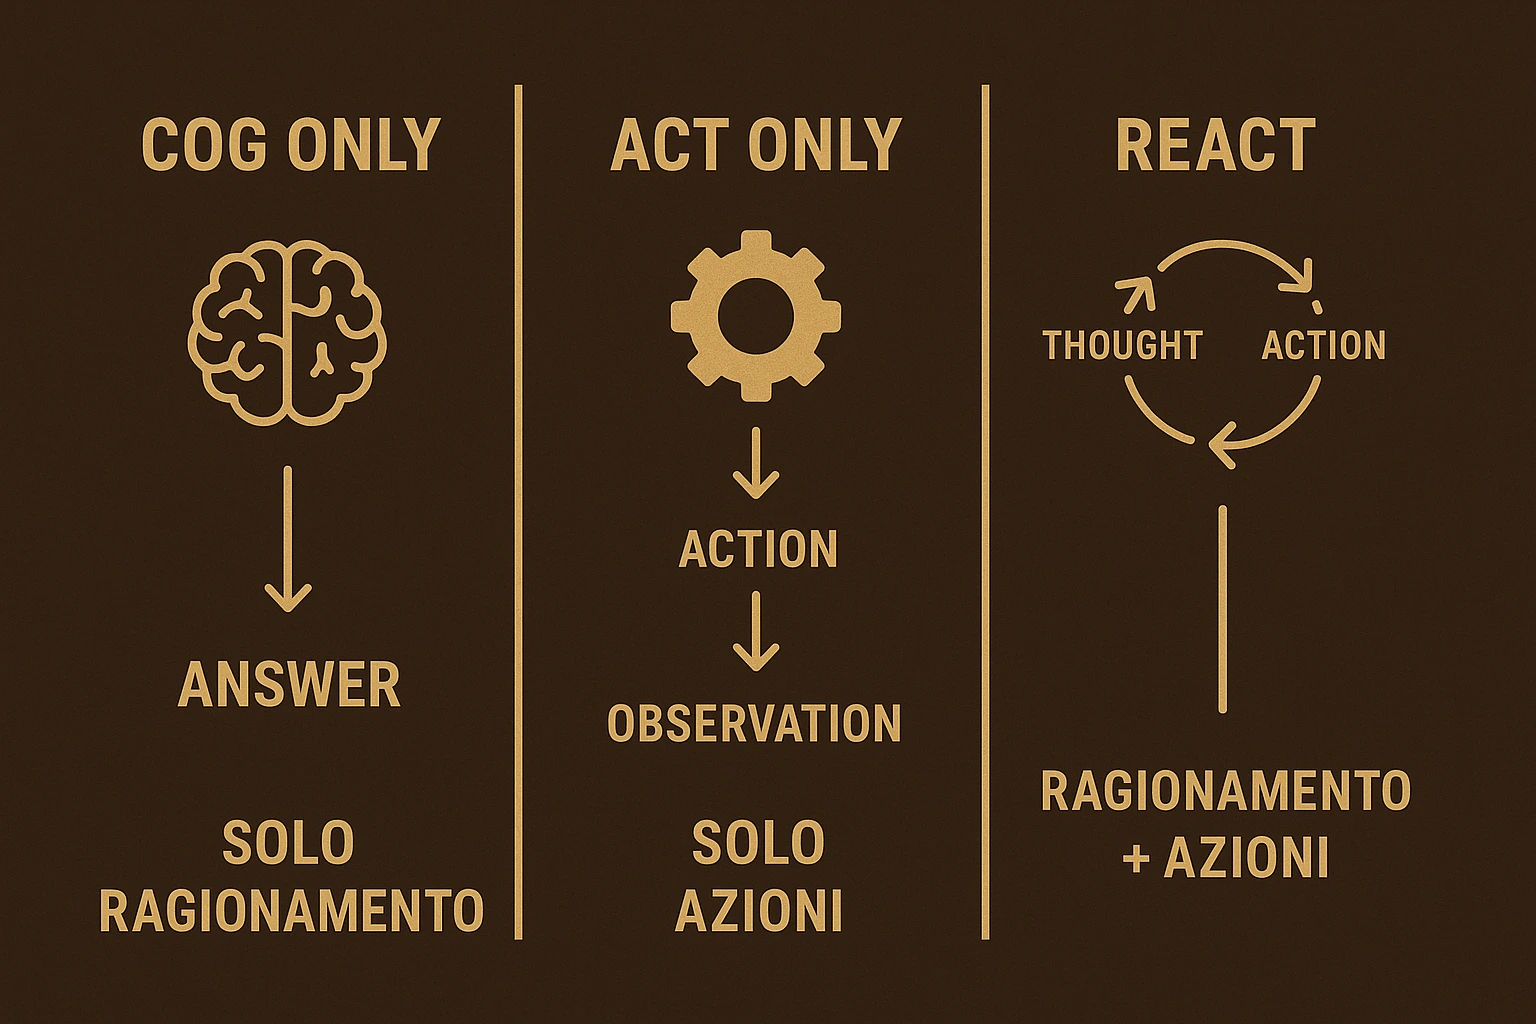
Dall'altra parte c'è l'approccio opposto: Act-only. Il modello riceve un obiettivo, esegue azioni, raccoglie risultati. Nessun ragionamento esplicito. È come dare a qualcuno un toolkit senza spiegargli cosa deve costruire — agisce, ma non sa sintetizzare. Non pianifica, non decompone il problema, non si adatta.
I risultati del paper lo mostrano con chiarezza. Su FEVER (fact verification), Act-only raggiunge il 58.9% — meglio del CoT (56.3%), perché almeno verifica i fatti. Ma su task che richiedono sintesi di informazioni multiple, crolla. Su HotpotQA, Act-only arriva al 25.7% — il peggiore di tutti.
Due approcci, due difetti complementari. Uno pensa ma non agisce. L'altro agisce ma non pensa.
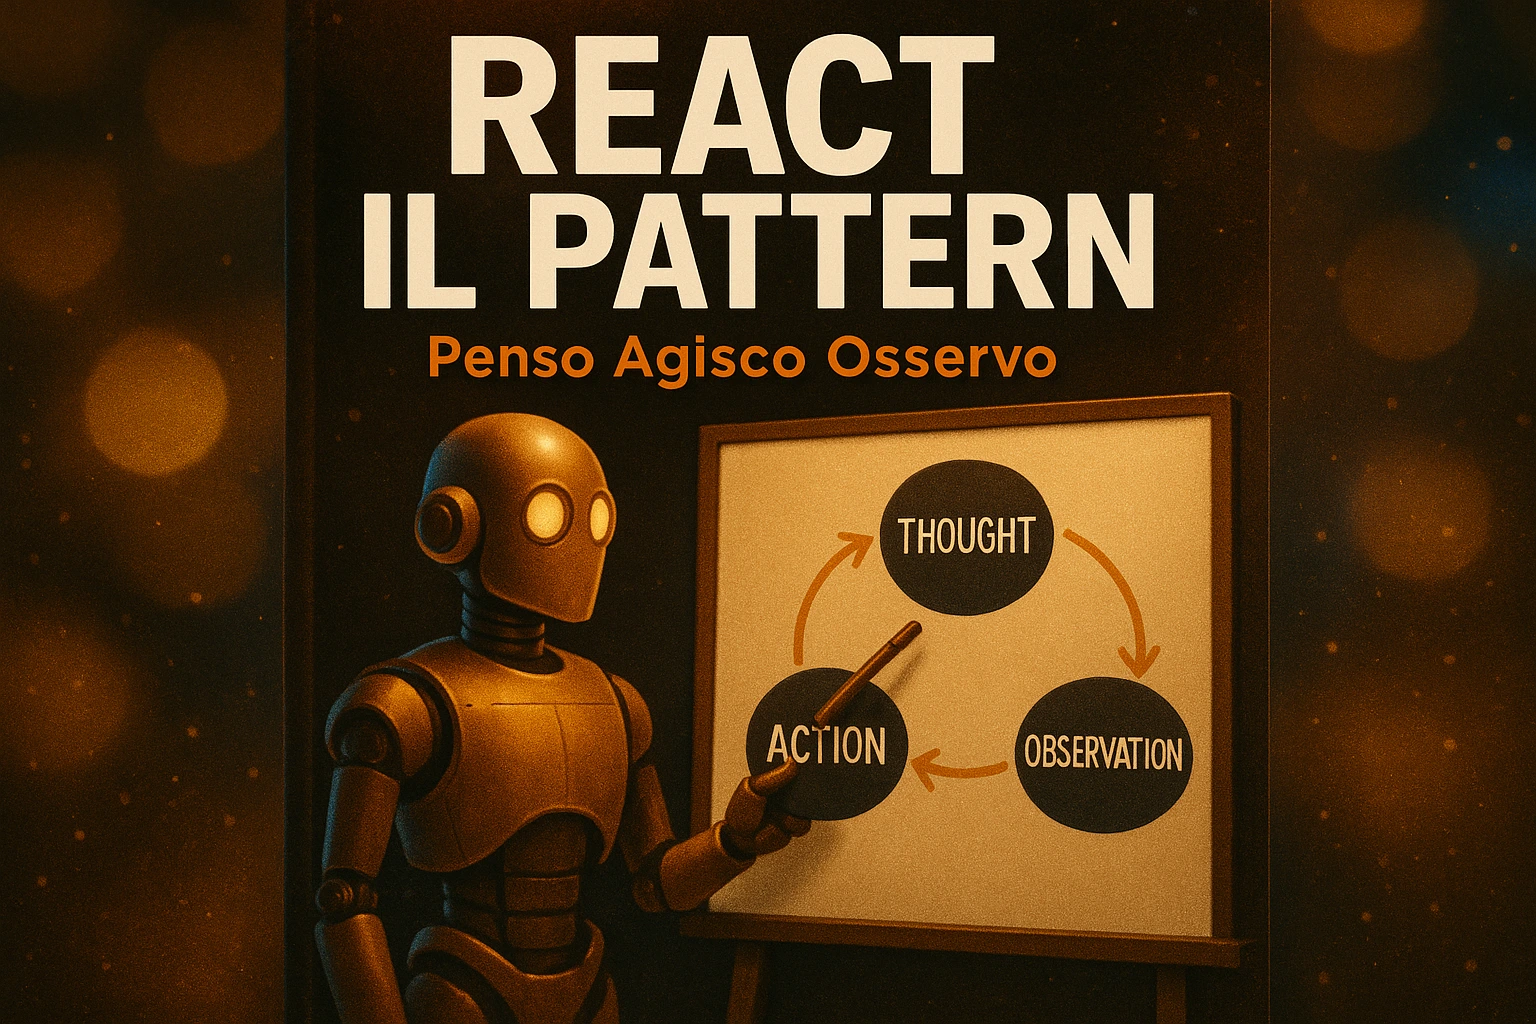
Il Pattern: Thought, Action, Observation
L'intuizione di Yao è disarmante nella sua semplicità: unisci entrambi. Fai alternare ragionamento interno e azioni esterne in un loop continuo.
Il modello segue tre fasi che si ripetono:
Thought — Il modello ragiona sullo stato attuale. Cosa sa? Cosa gli manca? Qual è il prossimo passo logico? Questo ragionamento è esplicito, scritto nel testo, leggibile da un umano.
Action — Il modello sceglie un'azione e la esegue. Cerca su Wikipedia, interroga un database, esegue un comando. Non genera testo — fa qualcosa nel mondo reale.
Observation — L'ambiente restituisce il risultato dell'azione. Il modello legge il risultato e lo integra nel suo contesto. Poi il ciclo riparte con un nuovo Thought.
È un while loop. Esattamente come un agente AI, il ciclo continua finché l'obiettivo non è raggiunto. Ogni iterazione arricchisce il contesto con informazioni reali — non generate, non "immaginate", ma osservate dall'ambiente esterno.
Il paper lo chiama grounding: ancorare il ragionamento a dati esterni. È la differenza tra un detective che formula teorie nella sua testa e uno che formula teorie, poi esce a verificarle sul campo, poi aggiorna le teorie in base a quello che trova.
Un Esempio Passo per Passo
Il paper usa un esempio da HotpotQA — domande che richiedono di incrociare informazioni da più fonti. Vediamo come ReAct affronta una domanda multi-hop.
Domanda: "What is the elevation range for the area that the eastern sector of the Colorado orogeny extends into?"
Thought 1: Devo cercare "Colorado orogeny" per capire dove
           si estende il settore orientale.
Action 1:  Search[Colorado orogeny]
Obs 1:     The Colorado orogeny was an episode of mountain building...
           The eastern sector extends into the High Plains.

Thought 2: Il settore orientale si estende nelle High Plains.
           Ora devo trovare l'elevation range delle High Plains.
Action 2:  Search[High Plains]
Obs 2:     High Plains refers to one of two distinct land regions...

Thought 3: Troppo generico. Devo cercare specificamente
           le High Plains negli Stati Uniti.
Action 3:  Search[High Plains (United States)]
Obs 3:     The High Plains are a subregion of the Great Plains.
           From east to west, they rise from around 1,800 to 7,000 ft.

Thought 4: Trovato. L'elevation range è da 1,800 a 7,000 piedi.
Action 4:  Finish[1,800 to 7,000 ft]
Quattro giri del loop. Quattro momenti in cui il modello si ferma, pensa, e decide cosa fare. Nessuna hallucination possibile sull'altitudine delle High Plains — il dato arriva direttamente dalla ricerca, non dalla "memoria" del modello.
Nota il Thought 3: la prima ricerca ("High Plains") restituisce un risultato troppo generico. Il modello se ne accorge, ragiona, e riformula la query. Un approccio Act-only avrebbe continuato con il risultato generico. Un approccio CoT-only non avrebbe mai cercato — avrebbe "ricordato" (forse sbagliando) l'altitudine.
I Numeri del Paper
I risultati sono significativi su più fronti. Partiamo dai task di decision-making interattivo, dove ReAct brilla di più.
ALFWorld: il dato più clamoroso
ALFWorld è un benchmark dove l'agente deve completare task domestici in un ambiente testuale — trovare oggetti, spostarli, interagire con l'ambiente. I metodi di imitation learning precedenti richiedevano tra 10^3 e 10^5 istanze di training per raggiungere il 37% di successo.
ReAct con 1-2 esempi nel prompt arriva al 71%. Quasi il doppio, con una frazione infinitesimale dei dati di training. Anche il peggior trial di ReAct (48%) batte il miglior trial dei metodi supervisionati. È un risultato che dice qualcosa di profondo: il ragionamento esplicito combinato con l'azione può compensare enormi quantità di dati di training.
Knowledge tasks: la storia è più sfumata
| Task | CoT | Act-only | ReAct | ReAct + CoT-SC |
|---|---|---|---|---|
| HotpotQA (EM) | 29.4 | 25.7 | 27.4 | 35.1 |
| FEVER (Accuracy) | 56.3 | 58.9 | 60.9 | 64.6 |
Su FEVER, ReAct da solo batte già CoT: 60.9 contro 56.3. Il grounding esterno conta — quando devi verificare fatti, cercarli è meglio che ricordarli.
Su HotpotQA la storia è più interessante. ReAct da solo (27.4) è leggermente sotto CoT (29.4). Ma la combinazione ReAct + CoT con Self-Consistency arriva a 35.1 — nettamente superiore a entrambi separatamente. Non è l'uno o l'altro — è l'uno e l'altro.
Fine-tuning: i modelli piccoli battono i grandi
Un dato meno citato ma importante: il paper mostra che il fine-tuning in formato ReAct è il miglior formato di addestramento attraverso tutte le dimensioni di modello testate. E modelli piccoli fine-tuned con ReAct battono modelli grandi con solo prompting.
Tradotto: non ti serve il modello più grande e costoso. Ti serve il pattern giusto.
Perché Funziona: Il Grounding Esterno
Il paper identifica con precisione il meccanismo che rende ReAct superiore. La citazione chiave:
"The reason-only baseline (chain-of-thought) suffers from misinformation as it is not grounded to external environments. The act-only baseline suffers from the lack of reasoning, unable to synthesize the final answer despite having the same actions and observation as ReAct."
CoT soffre di misinformazione perché non ha grounding. Act-only soffre di incapacità di sintesi perché non ragiona. ReAct risolve entrambi i problemi.
Il ragionamento serve a tre cose specifiche nel loop:
- Decomposizione — Scompone domande complesse in sotto-domande cercabili. "Devo trovare X, poi usare X per trovare Y."
- Tracking — Tiene traccia di cosa è stato trovato e cosa manca. "Ho trovato che il settore orientale si estende nelle High Plains. Ora mi manca l'altitudine."
- Adattamento — Reagisce a risultati inaspettati. "La ricerca 'High Plains' è troppo generica. Devo specificare meglio."
Le azioni servono a una cosa sola ma fondamentale: portare informazioni reali nel contesto del modello. Ogni Observation è un fatto verificato, non un token generato. Questo riduce progressivamente lo spazio per le hallucination — più azioni fai, più il tuo contesto è ancorato alla realtà.
ReAct È Ovunque (Anche Se Non Si Chiama Così)
Apri Claude Code e dai un task qualsiasi. Quello che succede sotto il cofano è descritto dalla documentazione Anthropic come un loop a tre fasi: gather context, take action, verify results. Tradotto: Thought, Action, Observation.
La documentazione è esplicita: "The agentic loop is powered by two components: models that reason and tools that act." E ancora: "Each tool use returns information that feeds back into the loop, informing Claude's next decision."
È ReAct. Non lo chiamano così, ma il pattern è identico.
Ogni tool use moderno è una Action nel senso di ReAct. Ogni risultato che torna al modello è un'Observation. Ogni momento in cui il modello decide cosa fare dopo — leggere un altro file? eseguire i test? modificare il codice? — è un Thought. Il loop ReAct è diventato l'architettura standard degli agenti AI senza che nessuno lo dichiari esplicitamente.
C'è una differenza implementativa importante, però. Il ReAct del paper del 2022 pre-datava il function calling nativo dei modelli. Le azioni venivano generate come testo libero e parsate con regex — fragile, soggetto a errori di formato. Oggi i modelli generano oggetti JSON strutturati per le chiamate tool — più affidabile, più scalabile.
| Aspetto | ReAct classico (2022) | Function Calling moderno |
|---|---|---|
| Come genera azioni | Testo parsato con regex | Oggetti JSON strutturati |
| Ragionamento visibile | Esplicito nel testo | Spesso implicito |
| Affidabilità parsing | Dipende dal prompt | Fine-tuned, più robusto |
| Scalabilità tool | Fatica con 10+ tool | Gestisce molti tool |
Il concetto è lo stesso. L'implementazione si è evoluta. Come osserva il team di Letta (ex MemGPT), le architetture degli agenti devono evolversi insieme alle capacità dei modelli, restando "in-distribution" rispetto ai dati di training. Il pattern ReAct sopravvive, ma la sua incarnazione tecnica cambia con ogni generazione di modelli.
Le Evoluzioni: Reflexion e LATS
ReAct ha aperto una linea di ricerca. Due evoluzioni meritano attenzione perché affrontano limiti specifici del pattern originale.
Reflexion: imparare dagli errori
ReAct procede in avanti — pensa, agisce, osserva, ripete. Ma cosa succede quando sbaglia? Il loop continua con le stesse informazioni, sperando di fare meglio. Non c'è un meccanismo esplicito per riflettere sull'errore e cambiare strategia.
Reflexion, pubblicato a NeurIPS 2023 da Noah Shinn, Yao e colleghi di Princeton, aggiunge esattamente questo. Dopo un fallimento, l'agente si ferma e genera una riflessione verbale: cosa è andato storto? Perché? Cosa fare diversamente? Questa riflessione viene salvata in una "episodic memory" e usata nei tentativi successivi.
Tre componenti: un Actor che genera azioni (il loop ReAct standard), un Evaluator che valuta se l'output è corretto, e un Self-Reflection model che produce cue verbali per migliorare al giro successivo.
I risultati sono notevoli: +22% su ALFWorld rispetto a ReAct base, +20% su HotpotQA, e il 91% pass@1 su HumanEval — il benchmark di coding — che al momento della pubblicazione batteva GPT-4 (80%).
LATS: ragionamento ad albero con ricerca
Se Reflexion aggiunge riflessione dopo l'errore, LATS (Language Agent Tree Search, ICML 2024) cambia la struttura stessa dell'esplorazione. Invece di seguire un singolo percorso Thought-Action-Observation, esplora un albero di possibili traiettorie usando Monte Carlo Tree Search.
È lo stesso principio del Tree of Thoughts applicato all'intero loop agente: a ogni nodo, il modello genera più possibili azioni, le valuta, e decide quale ramo seguire. Può fare backtracking se un percorso si rivela sbagliato.
Su HotpotQA, LATS raggiunge un Exact Match di 0.61 — più del doppio di ReAct base (~0.27-0.30). Su HumanEval, 92.7% pass@1 con GPT-4.
Il prezzo è ovvio: esplorare un albero costa esponenzialmente più che seguire un singolo percorso. Ma per task dove l'accuratezza vale più del costo, la differenza è significativa.
I Limiti Reali: Loop Infiniti e Costi Fuori Controllo
ReAct non è perfetto. E i suoi limiti diventano dolorosamente concreti quando lo usi in produzione.
Il problema dei loop infiniti
Il limite più pratico e costoso: l'agente che gira in tondo senza progredire. Un caso documentato descrive un agente che in 15 minuti ha eseguito oltre 60 step, spendendo circa 12 dollari per un task che normalmente ne costa 0.08. Un fattore 150x sul costo, senza produrre nulla di utile.
I loop non sono sempre ovvi. Quattro pattern ricorrenti:
- Hard Loop — L'agente chiama lo stesso tool con gli stessi argomenti, ripetutamente
- Soft Loop — Variazioni minime degli argomenti, stessa sostanza
- Retry Storm — Retry multipli su un errore che non può essere risolto dall'agente
- Semantic Loop — Riformula la stessa domanda in modi diversi senza fare progressi reali
Come nota chi ha studiato il problema: "Infinite loop almost never looks like a big outage; it is a slow degradation that eats budget and time." Non è un crash — è un'emorragia silenziosa.
Quando ReAct non serve
Non ogni task ha bisogno di un loop Thought-Action-Observation. Una classificazione, un'estrazione dati, una formattazione — sono task single-shot. Aggiungere il loop ReAct significa aggiungere latenza e costi senza beneficio.
Anthropic stessa, nella guida "Building Effective Agents", raccomanda di partire con prompt semplici e aggiungere complessità "only when it demonstrably improves outcomes". Parti con una singola chiamata. Se non basta, aggiungi un workflow. Se non basta, aggiungi il loop agente. ReAct è potente, ma non è la risposta a tutto.
Le difese pratiche
Se costruisci agenti, queste sono le guardie minime per il controllo del loop:
- Max iterations — Un limite rigido al numero di giri. Parti conservativo, aumenta solo se vedi benefici misurabili.
- Deduplica — Cache delle chiamate tool recenti. Se l'agente chiama lo stesso tool con gli stessi argomenti, fermalo.
- Progress detection — Se dopo N step non c'è un segnale nuovo (nuovo file letto, nuovo fatto scoperto, nuovo test passato), interrompi.
- Budget caps — Limiti su token totali e costo per task. Non negoziabili.
Il controllo del loop non vive nell'agente — vive nell'architettura runtime che lo circonda. L'agente ragiona e agisce. Il runtime decide quando fermarlo.
Un Pattern Diventato Invisibile
Simon Willison ha mostrato che un agente ReAct minimale si può scrivere in poche decine di righe di Python. Il system prompt dice al modello di operare in un loop "Thought, Action, PAUSE, Observation". Il codice esegue le azioni e restituisce i risultati. È tutto qui.
def query(question, max_turns=5):
    i = 0
    bot = ChatBot(prompt)
    next_prompt = question
    while i < max_turns:
        i += 1
        result = bot(next_prompt)
        actions = [action_re.match(a) for a in result.split('\n')
                   if action_re.match(a)]
        if actions:
            action, action_input = actions[0].groups()
            observation = known_actions[action](action_input)
            next_prompt = "Observation: {}".format(observation)
        else:
            return  # Nessuna azione = risposta finale
Poche decine di righe. Un while loop, un parser, una mappa di azioni. Questa è la struttura fondamentale di ogni AI agent che usi oggi — da Claude Code a Cursor a Codex. Ovviamente i sistemi reali aggiungono migliaia di righe di gestione errori, context management, tool orchestration e safety checks. Ma lo scheletro è questo.
Il fatto che il pattern sia diventato così fondamentale da essere invisibile è il segno del suo successo. Nessuno dice "sto usando il pattern ReAct" quando dà un task a Claude Code, così come nessuno dice "sto usando il pattern MVC" quando apre un'app web. Ma sotto il cofano, la struttura è quella.
Cosa Significa per Chi Sviluppa
ReAct ha definito un vocabolario e un'architettura che oggi sono lo standard de facto. Se usi agenti AI — e nel 2026, se scrivi codice, li usi — stai lavorando dentro il pattern Thought-Action-Observation che Yao ha formalizzato nel 2022.
Capire il pattern ti rende un utente migliore. Quando Claude Code fa una ricerca nel codebase, legge un file, ragiona, e poi decide di modificarlo — non è magia. È un giro del loop ReAct. Sapere che il Thought guida l'Action, e che l'Observation alimenta il Thought successivo, ti permette di capire perché l'agente fa certe scelte e come guidarlo quando prende la direzione sbagliata.
Capire i limiti ti salva soldi. Il loop infinito non è un bug raro — è un rischio concreto di ogni agente basato su ReAct. Sapere che esiste, riconoscere i pattern (retry storm, semantic loop), e avere le guardie in posizione (max iterations, budget caps, progress detection) è la differenza tra un tool che ti fa risparmiare tempo e uno che ti fa spendere 12 dollari in 15 minuti per nulla.
Il collegamento con CoT è diretto. Il Chain of Thought è il Thought del loop ReAct. ReAct prende quella capacità di ragionamento e la àncora al mondo reale attraverso le azioni. CoT ti insegna a pensare. ReAct ti insegna a pensare e agire. L'evoluzione è naturale, e capirla ti dà una mappa mentale di come funzionano gli agenti moderni dall'interno.
Un dottorando di 25 anni ha scritto un paper, e quel paper è diventato l'architettura invisibile di un'intera generazione di strumenti. Non succede spesso. Ma quando succede, vale la pena capire esattamente cosa ha scritto e perché funziona.
Fonti:
- Yao et al. — ReAct: Synergizing Reasoning and Acting in Language Models (ICLR 2023)
- Google Research Blog — ReAct: Synergizing Reasoning and Acting in Language Models
- Shinn et al. — Reflexion: Language Agents with Verbal Reinforcement Learning (NeurIPS 2023)
- Zhou et al. — Language Agent Tree Search (ICML 2024)
- Anthropic — Building Effective Agents
- Anthropic — How Claude Code Works
- HuggingFace — Agents Course: Agent Steps and Structure
- IBM — What is a ReAct Agent?
- Simon Willison — A simple Python implementation of the ReAct pattern
- Agent Patterns — Infinite Loop Problem